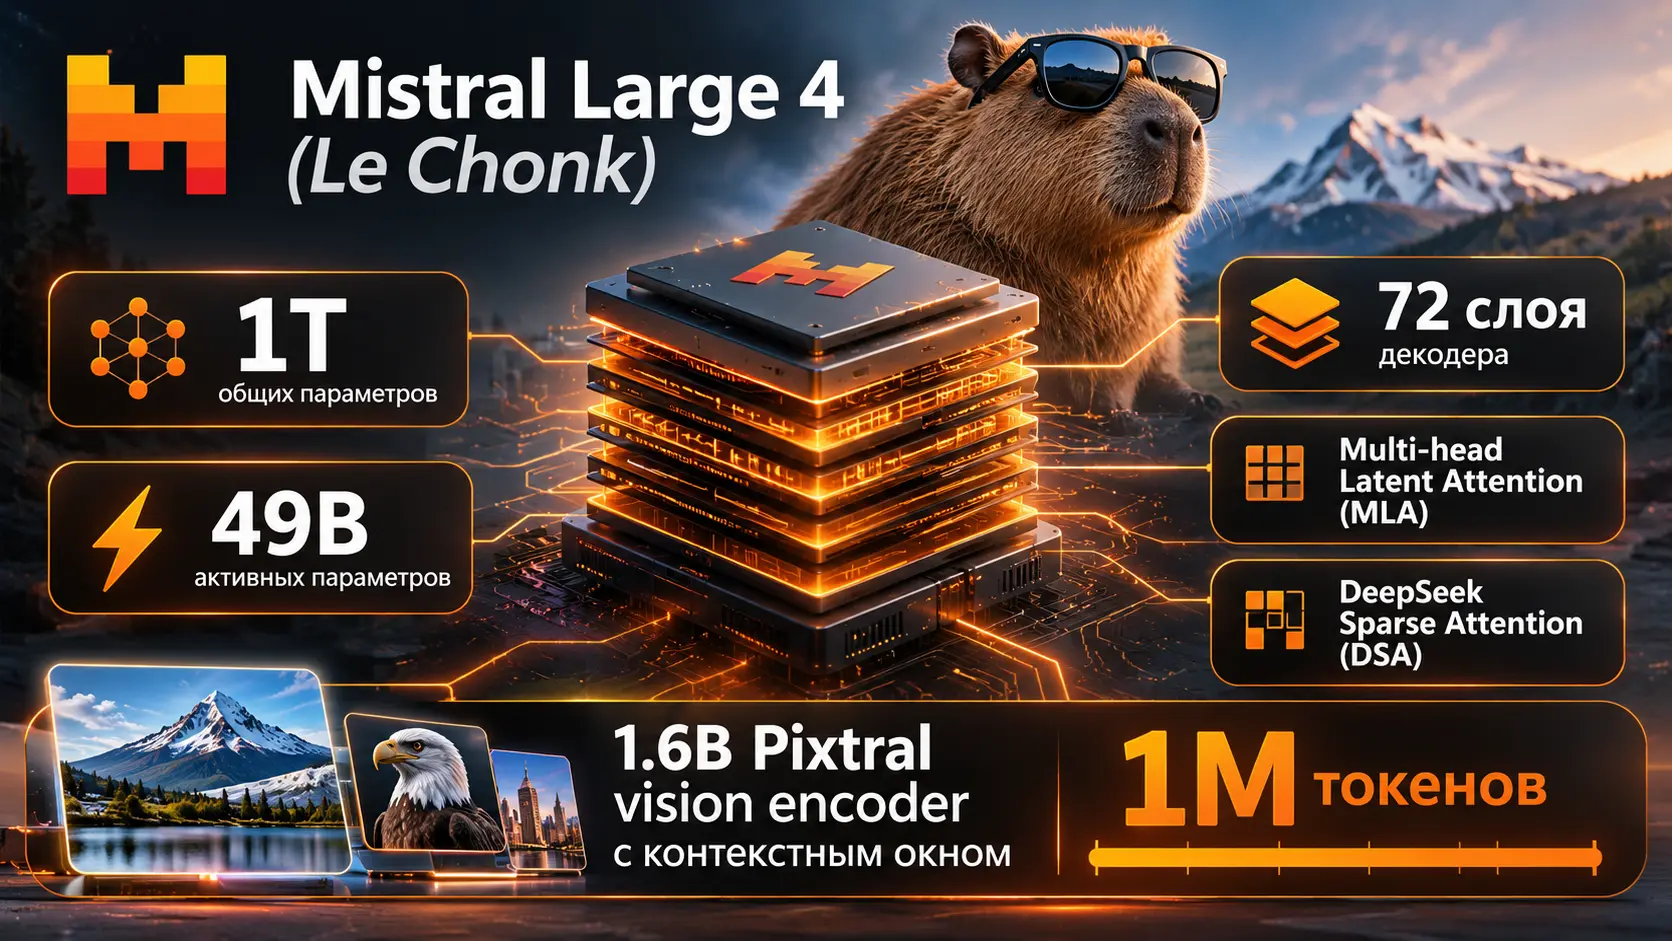
Архитектура Mixture-of-Experts с контекстом 1M токенов, оценка в кибербезопасности и кодинге, локальный запуск через vLLM и Llama.cpp, а также рецепты дообучения.
Что нового в Mistral Large 4 (Le Chonk)
Релиз Mistral Large 4 (получивший неофициальное кодовое имя Le Chonk) стал важным этапом в эволюции открытых больших языковых моделей 2026 года. Модель представляет собой массивную мультимодальную архитектуру с разделением экспертов (Mixture-of-Experts, MoE), объединяющую общий объем параметров порядка 1 трлн (1T) и активный объем около 49 млрд параметров (49B) на каждый обрабатываемый токен. Базовое контекстное окно модели расширено до 1 000 000 токенов (1M), что позволяет загружать в оперативную память полноценные репозитории программного кода, комплексные цепочки системных логов или многостраничную техническую документацию вместе с иллюстрациями.
Главным архитектурным новшеством модели является реализация концепции двойной разреженности (Dual Sparsity), которая распределяет вычислительную нагрузку по двум независимым координатам:
- Разреженность на уровне экспертов (Feed-Forward Sparsity): для каждого отдельного токена маршрутизатор активирует только ограниченный пул полносвязных сетей (FFN), оставляя основную массу параметров пассивной. Это обеспечивает высокую емкость запоминания фактов и логических правил без линейного роста затрат на вычисления 2. Разреженность на уровне контекста (Context Sparsity): механизм внимания использует динамический индексер, который для каждого сформированного запроса (query) отбирает только наиболее релевантные предшествующие позиции токенов в контексте, а не рассчитывает полное матричное произведение по всему миллионному окну.
Компания Mistral AI выложила чекпоинты весов в официальной коллекции на Hugging Face в двух основных форматах:
- FP8 (
mistralai/Mistral-Large-4-1T-A52B): стандартный релиз в 8-битном представлении с плавающей запятой, ориентированный на промышленные ускорители предыдущего и текущего поколений (NVIDIA H100, H200, B200). - NVFP4 (mistralai/Mistral-Large-4-1T-A52B-NVFP4): высокооптимизированный 4-битный формат, спроектированный для аппаратных тензорных ядер архитектуры NVIDIA Blackwell, позволяющий существенно сократить требования к объему VRAM и шине передачи данных.
Параллельно сообщество открытого ПО при поддержке команд Unsloth и
llama.cpp подготовило квантованные сборки в формате GGUF (ggml-org/Mistral-Large-4-1T-A52B-GGUF), сделав возможным локальный запуск модели на объединенных пулах оперативной памяти рабочих станций.Распространение весов регулируется лицензией Mistral Ecosystem Open-Weight License. Это специализированный дериватив лицензии MIT, который сохраняет полную свободу локального использования, изменения весов, создания дообученных версий (fine-tunes) и интеграции в корпоративные контуры, но устанавливает прямые юридические ограничения на коммерческую перепродажу модели сторонними провайдерами в формате «модель как услуга» (Model-as-a-Service, MaaS).
Возможности в области кибербезопасности
Одной из центральных областей специализации Mistral Large 4 стала практическая кибербезопасность с выраженным фокусом на оборонительные задачи (Defensive Security).
При использовании коммерческих закрытых frontier-моделей через облачные API команды информационной безопасности регулярно сталкиваются с проблемой ложных срабатываний входных классификаторов безопасности. Запросы, содержащие дампы трафика с признаками сетевых атак, фрагменты эксплойтов, декомпилированный вредоносный код или неструктурированные краш-логи уязвимых приложений, автоматически блокируются внешними фильтрами. Кроме того, зависимость от стороннего API несет критический инфраструктурный риск: отзыв доступа или сбой внешней платформы в момент активного реагирования на инцидент (Incident Response) оставляет группу защиты без аналитического инструмента.
Открытые веса полностью устраняют посредника: компания развертывает модель в изолированном сетевом контуре, самостоятельно определяя политику валидации данных и гарантируя бесперебойность аналитических пайплайнов.
Эффективность модели в задачах ИБ подтверждается независимыми тестами: - В специализированном бенчмарке Artificial Analysis Cyber Index модель Mistral Large 4 набрала 82% в сценарии сквозного воспроизведения уязвимости в открытом ПО и последующей генерации исправляющего патча. Согласно отчетам Mistral, ряд закрытых frontier-моделей показывают на этом тесте близкий к нулю результат, так как их защитные надстройки отказываются выполнять шаг воспроизведения уязвимости. - На соревновательном наборе Cybench, состоящем из 40 прикладных CTF-задач (Capture The Flag), модель успешно решила 93% заданий, продемонстрировав способность работать с нестандартными векторами атак и реверс-инжинирингом.
При этом модель не является «неконтролируемым генератором эксплойтов». На стандартных бенчмарках вредоносных запросов (JailbreakBench, StrongREJECT, AgentHarm) Mistral Large 4 демонстрирует более высокий средний процент обоснованных отказов (Refusal Rate), чем любая другая открытая модель аналогичного класса. Устойчивость к атакам внедрения инструкций проверена на бенчмарке Lakera B3, где модель показала результат 93.3% устойчивости к prompt-injection.
Открытый доступ к весам позволяет создавать автоматизированные контуры дообучения. Используя трассы рассуждений Mistral Large 4, инженеры могут применять библиотеку TRL для дистилляции защитных навыков в компактные модели-агенты, а также использовать алгоритмы обучения с подкреплением (RL), где успешная компиляция и прохождение юнит-тестов патчем выступают верифицируемой функцией награды.
Архитектура модели: MoE, MLA и разреженное внимание
Внутренняя структура текстового декодера Mistral Large 4 оптимизирована для удержания длинного контекста при умеренных требованиях к полосе пропускания памяти.
Декодер насчитывает 72 слоя со скрытой размерностью (hidden dimension) 6,144 и 64 головами внимания. Блок внимания базируется на механизме Multi-head Latent Attention (MLA), дополненном специализированным индексером разреженного внимания DeepSeek Sparse Attention (DSA):
- MLA (Multi-head Latent Attention): проецирует ключи и значения (KV) в низкоразмерное латентное пространство перед сохранением в кэш, снижая объем оперативной памяти под KV-кэш в несколько раз по сравнению со стандартным MHA/GQA. - DSA (DeepSeek Sparse Attention indexer): динамически сканирует контекст и выбирает для каждого query-вектора до 2,048 ключевых позиций, исключая необходимость вычисления полных матриц внимания для всего миллионного диапазона.
Организация слоев и маршрутизация MoE построена по следующей схеме: - Первый слой декодера выполнен в виде плотного полносвязного слоя (Dense FFN) для первичной стабилизации эмбеддингов. - Остальные 71 слой представляют собой MoE-блоки со 128 экспертами. Маршрутизатор на базе функции Softmax выбирает 4 специализированных эксперта для каждого токена. Дополнительно параллельно с выбранными экспертами всегда выполняется 1 общий разделяемый эксперт (Shared Expert). Таким образом, в обработке каждого токена постоянно участвуют 5 активных экспертов.
Для позиционного кодирования применена гибридная схема 3:1 RoPE к NoPE: три последовательных слоя декодера используют поворотные позиционные эмбеддинги (Rotary Position Embeddings), а каждый четвертый слой работает без них (NoPE), опираясь на внутреннее представление состояний. В качестве конкретной реализации RoPE задействован алгоритм LeRope — модификация YaRN-масштабирования с индивидуально обучаемым множителем для каждой частотной компоненты. Дополнительно модель реализует совместное использование (sharing) состояний KV между соседними слоями.
Энкодер изображений Pixtral
Мультимодальная обработка реализована через интеграцию визуального энкодера Pixtral объемом 1.6 млрд параметров.
Параметры визуального модуля: - 30 трансформерных слоев со скрытой размерностью 2,048 и 16 головами внимания. - Исходное изображение разбивается на сетку патчей фиксированного размера 14 × 14 пикселей. - Линейный проектор типа patch-merge выполняет пространственное слияние признаков с фактором 2, сжимая визуальную сетку и формируя последовательность эмбеддингов, подаваемых напрямую во входной поток текстового декодера.
Результаты бенчмарков: кодинг, безопасность и агентные задачи
В сводном независимом рейтинге Artificial Analysis Intelligence Index по состоянию на 29 октября 2026 года Mistral Large 4 зафиксирована на 5-й позиции среди всех открытых моделей мира, демонстрируя высокую конкурентоспособность в прикладных дисциплинах.
Модель оптимизирована под работу автономных агентов кодогенерации (Coding Agents), способных ориентироваться в файловой структуре, читать документацию, запускать тесты и исправлять ошибки сборки:
- На бенчмарке программных дефектов DeepSWE v1.1 модель набрала 61.7%. - В вопросно-ответной аналитике по кодовым базам SWE-Atlas-QnA зафиксирован результат 59.4%. - В среде управления консольным интерфейсом Terminal-Bench 4 модель получила 28.3%. - В интегральном индексе программных агентов Coding Agent Index результат составил 49.8%, что вывело Mistral Large 4 вперед относительно таких конкурентов, как DeepSeek V4 Pro (чекпоинт 0813) и Qwen3.8 Max.
В области комплексной автоматизации бизнес-процессов и решения длинногоризонтных офисных задач модель показала 59.9% на бенчмарке AutomationBench и достигла рейтинга 1,393 Elo в испытании AA-Briefcase.
Поддержка инференса и локальный запуск
Модель Mistral Large 4 поставляется с поддержкой «нулевого дня» (Day-0 Support) для всех основных инструментов инференса: библиотеки Transformers, высокопроизводительного движка vLLM и фреймворка Llama.cpp.
Важной особенностью архитектуры является встроенный механизм цепочки рассуждений (Reasoning Effort). Модель поддерживает три уровня глубины рассуждений:
low, medium и high (значение по умолчанию). Рассуждения нельзя выключить полностью: при передаче значения reasoning_effort: none модель интерпретирует команду как стандартный режим high.Инференс через Transformers
Интеграция с библиотекой Hugging Face Transformers опирается на класс
AutoModelForMultimodalLM и процессор AutoProcessor, который подготавливает текстовые и визуальные токены.Для параллелизации 1T-модели по нескольким видеокартам используется конфигурация
DistributedConfig, распределяющая веса по механизмам тензорного (TP) и экспертного (EP) параллелизма.Условный пример команды запуска распределенного скрипта на узле из 8 GPU:
Высокопроизводительный сервер vLLM и спекулятивное декодирование
Движок vLLM предоставляет оптимизированный бэкенд для работы с официальным чекпоинтом
NVFP4. Модель штатно комплектуется вспомогательным модулем DSpark drafter, предназначенным для спекулятивного декодирования (Speculative Decoding). Черновой драфтер генерирует кандидаты токенов на высокой скорости, после чего основная модель MoE верифицирует их за один прямой проход, повышая итоговую пропускную способность генерации в 1.5–2 раза.Шаблон команды запуска сервера vLLM с включенным экспертным параллелизмом и префиксным кэшированием:
После запуска сервера эндпоинт принимает стандартные HTTP-запросы по спецификации OpenAI Chat Completions на порту 8000.
Квантование и работа через Llama.cpp
Для локальных рабочих станций и серверов без специализированных ускорителей Blackwell сообщество выпустило линейку квантов GGUF:
IQ2_XXS, Q2_K, Q4_K_M, NVFP4, Q8_0 и BF16.Пример запуска локального сервера через утилиту
llama serve с 2-битным квантом:Инженерные замеры скорости инференса показывают следующие эксплуатационные характеристики:
- Apple Silicon (M3 Ultra с 512 ГБ Unified Memory): - Квант
Q2_Kзапускается на одном компьютере целиком в объединенной памяти. - Скорость обработки входного промпта (prefill): около 90 токенов/сек. - Скорость генерации ответа: около 15 токенов/сек 2. Серверный узел на 4 x NVIDIA RTX 6000 Pro: - ЧекпоинтNVFP4(в контекстном окне до 32K токенов): префилл 130–590 т/с, генерация ~10 т/с. - КвантIQ2_XXS(на коротком контексте): префилл 500 т/с, генерация 30 т/с. При росте контекста до 800K токенов скорость генерации падает до 3 т/с (префилл — 129 т/с), что обусловлено накладными расходами на вычисление разреженного внимания в деградированном 2-битном пространстве весов.
Тонкая настройка (Fine-tuning) с помощью TRL
Благодаря поддержке в экосистеме Hugging Face TRL (Transformer Reinforcement Learning), инженеры могут выполнять параметрически эффективное дообучение (PEFT / LoRA) модели сразу после релиза.
При тонкой настройке 1T MoE-модели критически важно корректно определить целевые модули для адаптеров LoRA. Адаптеры внедряются как в проекционные матрицы внимания (с учетом сжатия MLA), так и во внутренние слои экспертов FFN:
- Матрицы внимания:
q_proj,kv_a_proj_with_mqa,kv_b_proj,o_proj. - Матрицы вентилей и проекций MoE:gate_proj,up_proj,down_proj.
Для минимизации расхода видеопамяти при обучении на кластере из 8 ускорителей уровня NVIDIA B300 или H200 используется связка FSDP (Fully Sharded Data Parallel) и Expert Parallelism (EP).
В сценарии настройки многоязычного мышления (Multilingual Thinking) модель обучается генерировать скрытый блок рассуждений (
<thought>) на том естественном языке, который указан в системном промпте, сохраняя точность структурированного вывода при решении математических или программных задач. Для оптимизации пропускной способности пакетов в TRL включаются флаги packing = True (упаковка нескольких коротких примеров в единый контекст 4096 токенов) и assistant_only_loss = True (расчет градиентов исключительно по токенам ответа ассистента).Облачное развертывание: Inference Endpoints и Dell Enterprise Hub
Для enterprise-сценариев Hugging Face и компания Dell предложили готовые шаблоны развертывания под ключ без необходимости ручной сборки контейнеров.
На платформе Hugging Face Inference Endpoints доступен готовый профиль под кластер из 8 x NVIDIA H200 (141GB): - Модель запускается в формате FP8 под управлением движка vLLM с разделением весов через тензорный и экспертный параллелизм. - Активный спекулятивный модуль DSpark обеспечивает ускорение генерации с базовых 65 токенов/сек до 120–138 токенов/сек при высоком коэффициенте принятия черновых токенов в диалоговых сценариях. - Время до первого токена (TTFT): составляет около 0.6 секунды для промпта размером 1K токенов. При подаче четырех параллельных тяжелых запросов по 16K токенов суммарный префилл достигает 4,300 токенов/сек, а TTFT удерживается в диапазоне 8–9 секунд. - Пропускная способность под нагрузкой: достигает ~480 токенов/сек суммарно при одновременной обработке потока из 1,000 диалогов ShareGPT.
Развертывание через официальный CLI выполняется одной командой:
Для локальных корпоративных дата-центров интеграция реализована в Dell Enterprise Hub (DEH). Используя утилиту
dell-ai, администраторы могут развернуть контейнеризированный стек модели на серверах Dell PowerEdge (включая флагманские платформы XE9780 с ускорителями NVIDIA B300).Шаблон команды развертывания на сервере Dell:
Ограничения, лицензия и итоги
При планировании внедрения Mistral Large 4 в инфраструктуру предприятия необходимо учитывать комплекс эксплуатационных ограничений:
- Аппаратные требования: полноразмерные веса в формате FP8/NVFP4 требуют минимум 8 ускорителей уровня H100/H200/B200/B300. Запуск на более доступных конфигурациях возможен только через экстремальное квантование (IQ2/Q2), которое приводит к ощутимому падению скорости генерации (до 3 токенов/сек) на предельных контекстах свыше 500K токенов 2. Неотключаемый блок рассуждений: архитектура жестко ориентирована на предварительное рассуждение (reasoning tokens), что увеличивает задержку вывода на простых фактологических запросах, где развернутый логический вывод избыточен 3. Лицензионные рамки: лицензия Mistral Ecosystem Open-Weight License разрешает любое внутреннее корпоративное использование и встраивание в собственные сервисы, но запрещает бизнес-модель прямой перепродажи API (MaaS).
Заключение
Релиз флагманской мультимодальной модели Mistral Large 4 (Le Chonk) от Mistral AI задает новый технологический уровень для открытых решений в 2026 году. Благодаря архитектуре Mixture-of-Experts с общим объемом около 1 трлн параметров и 49 млрд активных параметров на токен, система обеспечивает высокую вычислительную эффективность. Контекстное окно в 1 000 000 токенов в паре со встроенным энкодером изображений Pixtral 1.6B позволяет без труда обрабатывать полные кодовые репозитории, объемные массивы системных логов и мультимодальную техническую документацию.
Модель демонстрирует впечатляющие результаты в сфере кодинга, агентных сценариев и кибербезопасности, достигая точности 82% при воспроизведении уязвимостей. Для практического внедрения доступны официальные веса FP8 и NVFP4, а также разнообразные GGUF-сборки от IQ2_XXS до BF16. Развертывание поддерживается через vLLM со спекулятивным декодированием, Transformers и llama.cpp, а дообучение реализуется с помощью библиотеки TRL.
Несмотря на открытый формат поставки под лицензией Mistral Ecosystem Open-Weight License, ключевым вызовом остается инфраструктурный барьер. Полноценная промышленная эксплуатация требует мощных 8-карточных GPU-кластеров, облачных сред Dell Enterprise Hub или Hugging Face Inference Endpoints, либо систем с 512+ ГБ объединенной памяти для квантованных сборок.
