4 правила текста для ответов нейросетей без кода 2026
Разбираем 4 правила текста для попадания в ответы нейросетей в 2026 году. Практическое руководство по GEO-оптимизации контента без сложного кода для бизнеса.
Готовим текст для ИИ
Как попасть в генеративную выдачу
ГЛАВНОЕ
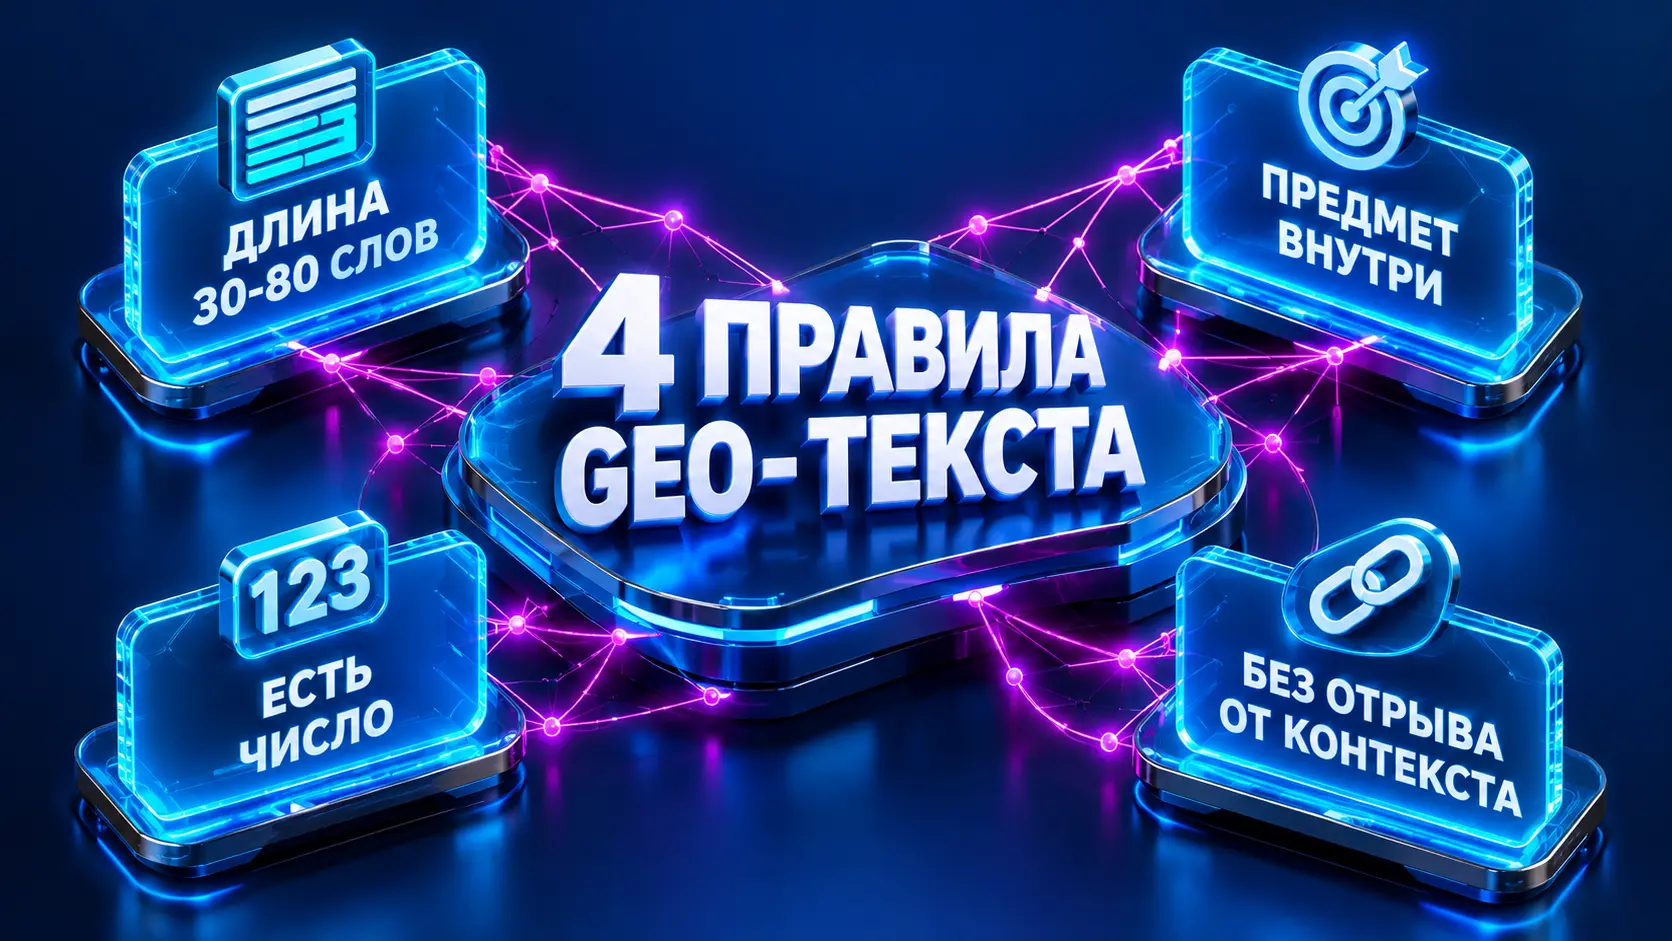
Поисковые нейросети вроде Perplexity и ChatGPT с веб-поиском цитируют не страницы целиком, а автономные смысловые фрагменты (чанки). Чтобы попасть в синтезированный ответ, абзац должен содержать от 30 до 80 слов, прямо называть предмет без местоимений, опираться на числовые факты и иметь законченную логику.
Подготовка к форматированию текста под нейросети: инструменты и предпосылки
Генеративная оптимизация текстов требует перехода от подбора ключевых слов к формированию гранулярных смысловых блоков, понятных алгоритмам фрагментации. В команде агентства Гибкий маркетинг мы перестроили работу с экспертными материалами: теперь каждый абзац проектируется как законченная информационная капсула, способная выжить в отрыве от основного документа. Если искусственный интеллект вырезает абзац со страницы, этот фрагмент обязан нести полную ясность о субъекте, объекте и числовых параметрах события.
Классическое SEO строилось на анализе плотности ключевых фраз, вложенности заголовков и ссылочной массе всего документа. В 2026 году архитектура поисковых систем сместилась в сторону Generative Engine Optimization (GEO). Большие языковые модели с веб-доступом (RAG-системы) не передают пользователю полотно страницы. Они сканируют документ, разделяют его на смысловые отрезки по тегам разметки, прогоняют через векторные эмбеддинги и ранжируют отдельные абзацы. Чтобы ваш ресурс попал в список источников Perplexity, ChatGPT Search или умных ассистентов Яндекса, нужно форматировать каждый фрагмент под правила нейросетевого парсинга.
Перестройка алгоритмов доставки контента затрагивает не только традиционный веб-поиск, но и экосистемы современных платформ обмена сообщениями. Поведение аудитории меняется: пользователи больше не переходят по десяткам ссылок, предпочитая готовые агрегированные ответы прямо в интерфейсе привычных сервисов.
Исторический факт
2024
Внедрение умных рекомендаций и ИИ-лент в мессенджерах
Крупнейшие каналы коммуникации трансформируют подачу информации: появление алгоритмических рекомендаций и умных лент меняет требования к дистрибуции контента. Материалы ранжируются на основе семантической плотности и автономности отдельных публикаций, а не только хронологии.
Чтобы систематизировать подход к оптимизации контента, команде маркетологов и авторов требуется ясное понимание технологического пайплайна современных генеративных поисковиков. Принципы фрагментации напрямую диктуют визуальную и логическую верстку корпоративного блога.
Обзор архитектуры Generative Engine Optimization
Механика работы RAG-систем при обработке коммерческих и экспертных сайтов
Фрагментация (Chunking)Разбивка страницы на автономные текстовые блоки по 30–80 слов без потери смысла
Векторный поискСопоставление пользовательского интента с эмбеддингами конкретных абзацев, а не сайта
Фильтрация контекстаИсключение из итогового промпта абзацев с размытыми формулировками и бессвязными отсылками
Генерация цитатыСинтез итогового ответа со ссылкой на первоисточник при наличии прямых фактов
Как поисковые ИИ выбирают абзацы со страницы сайта?
Поисковые нейросети отбирают абзацы через оценку семантической плотности и информационной автономности каждого текстового фрагмента. Согласно официальным рекомендациям инженерных команд Bing и Ahrefs, алгоритмы RAG не читают лонгрид последовательно от первого до последнего экрана. Краулер извлекает сырой HTML-текст, очищает его от навигационных элементов и дробит контентную область на смысловые фрагменты (чанки).
Далее система ранжирует полученные чанки относительно запроса пользователя. Если абзац содержит формулировку «Они увеличили показатели в два раза за прошлый месяц», нейросеть отбрасывает его. Модель не способна восстановить из соседних параграфов, кто именно скрывается за местоимением «они» и какой именно месяц имелся в виду. Цитату получает тот сайт, чей абзац содержит законченную конструкцию: имя бренда, название метрики, временной интервал и абсолютное значение. В нашей практике в Гибком маркетинге этот принцип доказал эффективность при разработке собственного продукта — автономного генератора SEO-статей, где каждый сгенерированный блок блога индексируется поисковыми системами за счет смысловой завершенности.
ИсследованиеЖурнал / Источник: Habr / Исследования поисковых алгоритмов
Исследование выборки цитирования Perplexity на 60 ответах
Резюме
Анализ 60 генеративных ответов Perplexity показал выборку из 113 процитированных абзацев среди 4390 параграфов на 79 релевантных страницах. Медианная страница отдавала в итоговый ответ модели всего 2 абзаца из 85 доступных, отдавая приоритет фрагментам с законченной мыслью.
Исследование подтверждает жесткую избирательность языковых моделей. Из 85 доступных на типичной странице параграфов фильтрацию проходят единицы. Это означает, что раздувание объема за счет пустых вводных конструкций напрямую снижает шанс ресурса быть упомянутым в качестве источника.
Какие инструменты нужны для аудита текста без кода?
Для проверки готовности текстов к генеративной выдаче достаточно четырех базовых инструментов без необходимости писать сложный серверный код. Мы рекомендуем маркетологам и редакторам использовать минималистичный стек, позволяющий контролировать структуру еще на этапе создания черновика.
Первичная работа ведется в Markdown-редакторах с визуальным подсчетом слов в каждом параграфе (например, Obsidian, Typora или VS Code). Для глубокой автоматической разметки используется локальный скрипт анализа семантических меток, не требующий навыков программирования. Финальная валидация осуществляется ручной проверкой через поисковые запросы в интерфейсе Perplexity. Четвертым элементом выступает матрица четырех контрольных признаков: длина блока, наличие сущности в теле абзаца, числовые данные и отсутствие смыслового разрыва.
Markdown-редакторы
Среда для набора текста с контролем границ абзацев и визуальным отображением структуры заголовков H2/H3.
Полигон для тестирования ранжирования фрагментов и анализа источников в реальной поисковой выдаче.
Матрица признаков GEO
Регламент самоконтроля автора: длина 30-80 слов, прямое имя субъекта, точные цифры, смысловая автономия.
Грамотно выстроенная работа с текстами не существует в вакууме. Чтобы сайт получал органический трафик из традиционных поисковиков и генеративных систем синхронно, важно объединять правила верстки с общей стратегией видимости. Подробно о гибридном подходе мы рассказывали в материале про SEO и GEO продвижение в Яндексе 2026, где описали адаптацию коммерческих страниц под нейросетевой режим поиска.
Почему длина абзаца 30–80 слов критична для цитирования нейросетью?
Ограничение длины абзаца рамками 30–80 слов обусловлено математической логикой формирования контекстного окна в RAG-системах. Анализ цитирования показывает, что параграфы короче 30 слов слишком часто признаются алгоритмом семантически неполноценными, а длинные блоки текста свыше 90–100 слов создают информационный шум при ранжировании кандидатов.
В текстах наших проектов в Гибком маркетинге мы опираемся на эмпирические замеры. Длинные абзацы грешат смешением нескольких тезисов: в начале автор формулирует проблему, в середине приводит доказательство, а в конце делает отвлеченное отступление. Поисковый робот не может уверенно сопоставить такой гигантский чанк с узким пользовательским вопросом. Слишком короткий абзац в 10–15 слов, напротив, выглядит как вырванная фраза. Золотой стандарт генеративной верстки — от 30 до 80 слов на один параграф.
41 слово
Медианная длина абзаца, выбранного нейросетью Perplexity в качестве источника
23 слова
Медианная длина пропущенного алгоритмом абзаца на тех же страницах сайтов
65%
Доля взятых в генеративный ответ абзацев, попадающих в диапазон 30–80 слов
+29 п.п.
Преимущество абзацев оптимальной длины внутри одного и того же документа
Какой объем абзаца чаще всего цитирует Perplexity?
Наибольшую вероятность цитирования в генеративном поиске имеют абзацы объемом от 35 до 55 слов, содержащие ровно одну законченную микротему. Замеры показывают выраженный куполообразный график распределения: вероятность включения текста в ответ резко падает при выходе за пределы диапазона 30–80 слов.
Когда система сканирует массив данных, она оценивает отношение полезного сигнала к общему количеству токенов. В абзацах длиной 10–20 слов плотность фактов может быть высокой, но модели не хватает контекстного окружения для валидации утверждения. В блоках объемом более 80 слов информационная плотность размывается вводными фразами и рассуждениями.
Распределение цитируемости абзацев в зависимости от их длины в словах
Приведенные значения иллюстрируют поведение ранжирующего алгоритма: фокус внимания поискового интеллекта сосредоточен в центральном коридоре. Если автор дробит материал на короткие однострочные предложения ради мнимой динамики, он собственноручно выводит публикацию из поля зрения нейросетей.
Как склеить короткие абзацы-обрывки в законченную мысль?
Склеивание фрагментарных предложений в единый смысловой блок выполняется по схеме «Тезис — Раскрытие — Факт». Популярный в социальных сетях прием оформления каждого предложения с новой строки губителен для SEO в эпоху искусственного интеллекта. Поисковый парсер воспринимает одиночные строки как разрозненные элементы списка, лишенные контекста.
Чтобы устранить этот дефект, автор объединяет три-четыре связанных по смыслу суждения в монолитный параграф. Первое предложение формулирует утверждение. Второе объясняет причинно-следственную связь. Третье фиксирует результат или числовое подтверждение. В итоге получается самодостаточный блок на 45–60 слов, идеально подходящий для извлечения поисковым краулером.
Сравнение форматов верстки параграфов для поисковых систем
Короткие обрывки (10–20 слов)
Плюсы
+Быстро просматриваются при беглом чтении с экрана смартфона
+Создают иллюзию динамичного ритма повествования
+Просты в написании без глубокой работы над логикой
Минусы
-Теряют всякий смысл при автономном извлечении краулером
-Игнорируются нейросетями из-за дефицита контекста
-Приводят к пессимизации страницы в выдаче RAG-систем
Автономные абзацы (30–80 слов)
Плюсы
+Сохраняют полную смысловую ясность без соседних блоков
+Идеально вписываются в окно цитирования Perplexity и ChatGPT
+Увеличивают шансы попадания в сводные ответы на 29 процентных пунктов
Минусы
-Требуют жесткой дисциплины мышления и редактуры
-Исключают возможность написания бессодержательного текста
Вывод
Для генеративной оптимизации текста критически важно отказаться от рубленых однострочников и объединять связанные мысли в монолитные блоки объемом от 30 до 80 слов.
Мультиканальная система
привлечения клиентов
из 9 источников + сайт в подарок
Получите расчет бюджета и количества заявок
для вашего проекта – бесплатно за 24 часа
Интеграция контентных решений в единый маркетинговый контур помогает системно развивать бренд во всех доступных каналах. Подробный разбор того, как новые технологии меняют трафик и воронки продаж, мы представили в исследовании трендов интернет-рекламы в 2026 году, где наглядно показана связка генеративного контента и многоканального маркетинга.
Как назвать предмет внутри абзаца, чтобы нейросеть не потеряла контекст?
Прямое именование предмета или бренда внутри каждого отдельного абзаца предотвращает потерю контекста при векторной фрагментации страницы. Когда языковая модель разделяет документ на куски, заголовок статьи или раздела H2 далеко не всегда привязывается к телу каждого параграфа.
В агентстве Гибкий маркетинг мы внедрили жесткий стандарт Entity Naming: если в абзаце речь идет о конкретном сервисе, методологии или показателе, автор обязан употребить точное имя сущности в первом или втором предложении. Замена ключевого термина местоимениями («эта программа», «данный подход», «наш метод») превращает абзац в анонимный обрывок. Для человека, читающего страницу целиком, связь понятна. Для нейросети, сканирующей отдельный эмбеддинг, ценность такого блока равна нулю.
«Фраза «Выручка компании выросла на 3% за квартал» сама по себе не говорит, о какой компании и каком квартале речь. В исправленной версии в тот же фрагмент дописаны название компании, квартал и выручка за прошлый период. Абзац попадает в ответ без соседей, поэтому имя предмета должно стоять в нём самом.
Инженерная команда AnthropicПубликация по методологии Contextual Retrieval
Почему местоимения и отсылки убивают смысл фрагмента?
Местоимения и безадресные указательные конструкции разрушают внешнюю валидность смыслового чанка. Если параграф начинается со слов «Этот инструмент позволяет автоматизировать рутину», алгоритм векторного поиска присваивает ему низкий скор релевантности по конкретному брендовому или категорийному запросу.
При этом эмпирические замеры опровергли популярный миф: вводные слова и союзы вроде «Поэтому» или «При этом» сами по себе не блокируют цитирование. Они допустимы, если следом за ними сразу называется предмет. Главная ошибка кроется именно в местоименной замене субъекта действия. Взятые в выдачу абзацы содержат имя предмета внутри текста в 80–85% случаев.
Параметр анализа параграфа
Взятые абзацы (все)
Пропущенные абзацы (все)
Взятые (30–80 слов)
Пропущенные (30–80 слов)
Начало со слова-отсылки («это», «поэтому»)
2,7%
3,6%
4,1%
4,5%
Наличие числовых данных
36%
27%
36%
33%
Предмет прямо назван внутри блока
80%
58%
85%
76%
Длина в коридоре 30–80 слов
65%
34%
100%
100%
← Прокрутите вправо →
Статистика демонстрирует: присутствие явного наименования предмета внутри абзаца повышает вероятность его извлечения с 58% до 80%. В группе калиброванных по длине фрагментов этот показатель достигает 85%.
Как добавить контекст в абзац по методу Anthropic?
Метод Contextual Retrieval предполагает насыщение каждого информационного блока тремя опорными координатами: субъект, временной маркер и сравнительная база. Вместо того чтобы полагаться на контекст предыдущего параграфа, автор интегрирует необходимые параметры непосредственно в структуру текущего предложения.
Вместо абстрактных описаний («мы внедрили автоматизацию и срезали издержки») формула требует предельной детализации («команда агентства Гибкий маркетинг внедрила парсеры трендов, сократив время подготовки контента на 40% во втором квартале 2026 года»). Подобная формулировка не требует пояснений, легко векторизуется и становится идеальным кандидатом на цитату в умном поиске.
Трансформация абстрактного абзаца в автономный GEO-фрагмент
Пример переработки текста по принципам контекстной самодостаточности Anthropic
Слабый текст с местоимениями
Выручка компании выросла на 3% за последний квартал благодаря внедрению новой системы
Она позволила сократить издержки на обработку клиентских обращений без расширения штата операторов
Это подтвердило правильность выбранного вектора развития на текущий финансовый период
Оптимизированный автономный чанк
Выручка агентства «Гибкий маркетинг» выросла на 3% за третий квартал 2026 года по сравнению с предыдущим периодом
Внедрение нейросетевых сценариев квалификации заявок снизило стоимость обработки лида без привлечения дополнительного персонала
Фрагмент получил полную автономность: названы компания, отчетный период, инструмент и конкретная бизнес-метрика.
Четкая фиксация метрик и сущностей напрямую перекликается с практикой прозрачной аналитики в платном трафике. Чтобы глубже разобраться в оцифровке результатов и правильном расчете эффективности, изучите наш гид по метрикам онлайн-рекламы от CPC до ROMI, где приведены проверенные формулы оценки маркетинговых вложений.
Зачем добавлять числа в каждый смысловой блок текста для генеративной выдачи?
Наличие чисел в смысловом блоке выступает для поисковых систем главным маркером фактологической достоверности и экспертности (E-E-A-T). Языковые модели обучены отдавать приоритет материалам, содержащим проверяемые данные, проценты, даты и финансовые показатели.
В команде Гибкого маркетинга мы рассматриваем числа как якорные сущности. Текст, лишенный конкретных количественных величин, алгоритм воспринимает как субъективное рассуждение или клише. Когда пользователь задает поисковой нейросети вопрос «Какова эффективность внедрения ИИ-агентов?», модель ищет чанки, где указаны конкретные проценты экономии времени, рублевые затраты или сроки окупаемости.
ИсследованиеЖурнал / Источник: Habr / Исследования структуры выдачи нейросетей
Влияние числовых параметров на выборку чанков в Perplexity
Резюме
Среди всех извлеченных в генеративные ответы фрагментов 36% содержали минимум одно числовое значение против 27% у пропущенных параграфов. При контроле длины (в выборке 30–80 слов) числовое присутствие сохранялось на уровне 36% у цитируемых блоков, что подтверждает важность фактуры.
Числовые параметры служат опорными точками для алгоритмов верификации ответов в RAG-системах. Современный поисковый ИИ сопоставляет данные из нескольких источников. Если сайт публикует точные метрики, а не размытые формулировки, вероятность попадания такого ресурса в перечень первоисточников возрастает.
Нейросети отдают предпочтение разным типам количественных данных в зависимости от их роли в доказательной базе абзаца. Мы составили рейтинг типов данных на основе их устойчивости в ответах языковых моделей.
Рейтинг влияния типов данных на включение в генеративный ответ
Относительные изменения (проценты, доли, коэффициенты роста)
5
Абсолютные финансовые значения (бюджеты, выручка, стоимость в рублях)
4
Временные маркеры (кварталы, годы, таймлайны реализации)
4
Порядковые числительные и списки параметров
3
Какие метрики лучше всего работают в GEO-оптимизации?
В генеративной оптимизации лучше всего работают специализированные бизнес- и технические метрики, привязанные к реальному контексту задачи. Использование абстрактных круглых чисел («увеличили продажи на 100%») вызывает скепсис как у пользователей, так и у антиспам-фильтров поисковиков. Напротив, точные показатели с десятыми долями или жесткими рамками диапазонов воспринимаются нейросетью как результаты реальных измерений.
Эволюция поискового маркетинга требует от бизнеса одновременного присутствия в классической органической выдаче и в генерируемых ответах нейросетей. Понимание фундаментальных различий между SEO и GEO позволяет грамотно распределять ресурсы на подготовку контента.
Трансформация подходов: классическое SEO против современной GEO-оптимизации
Классическое SEO
Плюсы
+Фокусируется на позициях всего документа в поисковом индексе
+Опирается на частотность ключевых запросов и мета-теги Title/H1
+Учитывает ссылочный профиль и поведенческие факторы страницы
Минусы
-Игнорирует автономность отдельных абзацев внутри лонгрида
-Проигрывает при сжатии документа в краткий генеративный ответ
-Не защищает контент от потери контекста при машинном рерайте
Генеративная оптимизация (GEO)
Плюсы
+Фокусируется на извлечении конкретных смысловых чанков (30–80 слов)
+Строится на формуле 'субъект + действие + конкретное число'
+Обеспечивает прямое цитирование бренда в интерфейсах нейросетей
Минусы
-Требует полной переработки редполитики и структуры статей
-Не гарантирует трафик на сайт, если пользователь удовлетворен кратким ответом
Вывод
В 2026 году бизнес обязан комбинировать оба подхода: классическое SEO обеспечивает первичное обнаружение страницы краулером, а правила GEO гарантируют попадание фрагментов в итоговый ответ нейросети.
Как проверить текст скриптом на Python без навыков программирования?
Автоматизация проверки текста позволяет быстро выявить параграфы, которые не соответствуют критериям извлечения в генеративных поисковиках. Редактору или маркетологу не требуется изучать программирование: достаточно запустить готовый скрипт через стандартную командную строку операционной системы.
В команде Гибкого маркетинга мы автоматизируем контентные процессы на всех уровнях — от парсинга трендов до автопостинга и создания профильных блогов. Подход к анализу текста через простой Python-скрипт исключает человеческий фактор: программа за секунду размечает длинные статьи и подсвечивает проблемные зоны.
Вайб-кодинг и ИИ-автоматизация
Александр Антощенко
Эксперт по нейросетям и автоматизацииГибкий Маркетинг
Сооснователь рекламного агентства «Гибкий Маркетинг». Занимаюсь нейросетями и автоматизацией: ИИ-контент (видео, Reels, креативы, тексты), вайб-кодинг приложений и сервисов, парсеры, ИИ-агенты и автопостинг. Автор нашего генератора SEO-статей — ставим клиенту блог под ключ, статьи индексируются и приводят бесплатный поисковый трафик.
Запуск скрипта проверки Markdown-файлов занимает менее двух минут и состоит из пяти последовательных действий. Скрипт очищает документ от кода, таблиц и ссылок, анализируя исключительно текстовые параграфы на соответствие четырем критериям.
Проверьте наличие Python 3 в системе через команду python3 --version в терминале macOS/Linux или командной строке Windows. [NEEDS SOURCE: актуальная минорная версия Python 3 на 2026 год]
2
Сохранение скрипта
Создайте файл marks.py в папке с вашими статьями и вставьте в него код функции анализа регулярными выражениями.
3
Подготовка статьи
Сохраните черновик текста в формате Markdown (.md), убедившись, что абзацы разделены пустыми строками.
4
Вызов проверки
Выполните команду python3 marks.py article.md нейросеть, передав путь к файлу и главное ключевое слово темы.
5
Получение отчета
Изучите построчный консольный вывод, где каждому абзацу присвоена комбинация из четырех бинарных меток.
Сам код скрипта компактен и использует исключительно стандартную библиотеку Python:
import re, sys

LINK = re.compile(
    r"^(?:это\w*|эт(?:от|а|и|им|ого|ой|их|ому|у|ими)|он|она|они|оно|"
    r"так(?:ой|ая|ое|ие)?|также|при этом|поэтому|однако|кроме того|здесь|там|тогда)\b",
    re.I
)

def marks(par, subject):
    t = re.sub(r'^[\s"«“(\-–—•\d.)]+', "", par.lower().replace("ё", "е"))
    stem = subject.lower().replace("ё", "е")[:max(4, len(subject) - 2)]
    return {
        "длина": 30 <= len(par.split()) <= 80,
        "отсылка": bool(LINK.match(t)),
        "число": bool(re.search(r"\d", par)),
        "предмет": stem in t
    }

text = re.sub(r"`{3}.*?`{3}", "", open(sys.argv[1], encoding="utf-8").read(), flags=re.S)
for par in text.split("

"):
    par = re.sub(r"\[([^\]]*)\]\([^)]*\)", r"\1", par.strip())
    if not par or par.startswith(("#", "!", "*", "|")):
        continue
    m = marks(par, sys.argv[2])
    print(" ".join(k[:3] + ("+" if v else "-") for k, v in m.items()), "|", par[:50])
Ожидаемый результат выполнения команды в консоли — список строк с префиксами статусов. Способ проверки: появление строк вида дли+ отс- чис+ пре+ | Текст начала абзаца..., что подтверждает корректную обработку файла.
Как интерпретировать метки скрипта и исправлять ошибки?
Интерпретация консольного вывода строится на последовательном анализе четырех трехбуквенных маркеров для каждого параграфа. Значение со знаком плюс означает соответствие критерию, знак минус указывает на потенциальную проблему.
Метка консоли
Диагностированное состояние
Рекомендуемое действие автора
`дли-`
Длина абзаца менее 30 либо более 80 слов
Если блок короче 30 слов — склеить с логическим соседом. Если длиннее 80 — разделить на два параграфа
`отс+`
Абзац начинается с отсылочного союза («поэтому», «при этом»)
Проверить наличие прямого имени предмета следом. Если предмет назван, метку можно игнорировать
`чис-`
В теле абзаца отсутствуют цифры и количественные маркеры
Добавить в текст конкретную метрику, процент, год, рублевую сумму или временной интервал
`пре-`
В абзаце отсутствует корень ключевого слова темы
Заменить абстрактные местоимения («система», «он») на точное наименование анализируемой сущности
← Прокрутите вправо →
Первым делом редактор устраняет метки дли- и пре-. Именно связка оптимального объема и наличия имени предмета создает базу для цитирования фрагмента поисковой нейросетью.
Какие частые ошибки мешают тексту попасть в ответы нейросетей?
Ошибки оптимизации текста под генеративную выдачу сводятся к игнорированию принципов модульности контента и нарушению правовых норм маркировки коммерческой информации. Поисковые краулеры 2026 года умеют оценивать не только семантику, но и юридическую чистоту и прозрачность первоисточника.
Если коммерческий текст содержит рекламные заявления, но опубликован без соблюдения законодательных требований, доверие поисковых систем к домену снижается. Легальность контента становится обязательным фактором ранжирования в белом бизнесе.
Закон / ГОСТФедеральный закон № 38-ФЗ, статья 18.1
Обязательная маркировка интернет-рекламы
Распространение рекламы в сети Интернет допускается только при условии присвоения идентификатора рекламы (erid) и передачи сведений о рекламодателе и параметрах кампании в Единый реестр интернет-рекламы (ЕРИР) через оператора рекламных данных.
Соблюдение требований закона защищает бизнес от регуляторных рисков и формирует высокий траст площадки в поисковых системах.
Какие типичные ошибки допускают копирайтеры?
Типичные ошибки копирайтеров при подготовке экспертных материалов проистекают из устаревших привычек веб-райтинга начала 2020-х годов. Попытки искусственно растянуть объем или разбить текст на эмоциональные однострочники разрушают машинную логику RAG-систем.
В агентстве Гибкий маркетинг мы выделяем четыре критических дефекта контента, которые гарантированно закрывают сайту дорогу в ответы поисковых нейросетей.
Монолитные стены текста
Параграфы от 100 слов с несколькими разнородными мыслями. Нейросеть не может выделить суть и отбрасывает блок целиком.
Смысловые обрывки
Предложения по 8–15 слов, вынесенные в отдельные абзацы. В отрыве от страницы они теряют контекст и бракуются парсером.
Местоименная анонимность
Обилие слов 'это', 'данный подход', 'наша методика'. Без точного названия бренда алгоритм не понимает, о чем речь.
Фактологическая пустота
Тексты без цифр, дат и процентов. Описательные прилагательные вызывают низкое доверие у ранжирующего агента.
Для глубокой автоматизации создания и проверки материалов продвинутые команды используют инструменты консольных языковых моделей. О том, как выстроить связку без рутины, читайте в нашей инструкции про 5 готовых сценариев Claude Code для маркетолога, где подробно описана консольная генерация UTM-меток и парсинг данных.
Финальный чек-лист проверки статьи
Перед публикацией материала на сайте контент-команда обязана провести ревизию верстки по контрольному списку критериев генеративной оптимизации.
Чек-лист подготовки статьи к генеративной выдаче (GEO)
Калибровка объема параграфов • Каждый абзац содержит от 30 до 80 слов. Исключены бессвязные однострочники и полотна текста свыше 90 слов.
Именование сущностей внутри чанков • В каждом параграфе субъект и объект названы явными именами, местоимения 'это' и 'он' сведены к минимуму.
Плотность числовых фактов • В ключевых смысловых блоках присутствуют проверяемые данные: проценты, рублевые суммы, периоды или метрики.
Автономия каждого смыслового блока • Любой абзац, извлеченный со страницы отдельно от статьи, полностью понятен читателю и краулеру.
Валидация консольным скриптом • Статья проверена через marks.py, критические метки длины и отсутствия предмета устранены.
Юридическая чистота и маркировка • Если в материале присутствуют коммерческие интеграции, соблюдены требования 38-ФЗ с передачей данных в ЕРИР.
Понимание тонкостей алгоритмов избавляет от необходимости тратить время на бессмысленную редактуру. Ниже собраны ответы на практические вопросы специалистов, внедряющих GEO-подход.
Частые вопросы о форматировании текстов под нейросети
Насколько жестким является правило длины в 30–80 слов?
Это эмпирическое наблюдение на выборке ответов Perplexity, где такие абзацы цитировались на 29 процентных пунктов чаще. Это не догма, но надежный математический ориентир для RAG-систем.
Нужно ли вручную вырезать слова «это» и «поэтому» в начале абзацев?
Исследования подтверждают, что сами по себе союзы и вводные слова не мешают цитированию, если за ними сразу следует прямое наименование предмета. Тратить часы на их тотальную зачистку бессмысленно.
Работают ли эти 4 правила для ChatGPT Search и умного поиска Яндекса?
Да, архитектура RAG-систем у всех современных платформ едина: разбивка на чанки, векторное сравнение и фильтрация. Принципы контекстной автономии универсальны для любых генеративных поисковиков.
Что скрипт marks.py делает с таблицами, списками и программным кодом?
Скрипт автоматически отфильтровывает код, таблицы и заголовки, проверяя только связные текстовые абзацы. Табличные данные ранжируются краулерами по отдельным специфическим алгоритмам.
Заключение
Подготовка коммерческих и экспертных материалов к попаданию в ответы нейросетей знаменует переход от механического насыщения ключевыми словами к прецизионной смысловой верстке. Генеративная оптимизация требует, чтобы автор мыслил не страницами, а отдельными информационными блоками. Соблюдение баланса длины от 30 до 80 слов, прямое указание брендов и терминов внутри каждого фрагмента и подкрепление тезисов твердыми цифрами гарантируют, что ваш контент будет востребован RAG-системами в 2026 году.
В агентстве Гибкий маркетинг мы выстраиваем сквозные процессы работы с контентом: от тренд-вотчинга нашими парсерами в Telegram, YouTube и VK до автоматизированного создания экспертных блогов, которые органично цитируются поисковыми системами и приводят клиентов в бизнес.
СТРАТЕГИЧЕСКИЙ ВЕРДИКТ ПО ВНЕДРЕНИЮ GEO В КОНТЕНТ-МАРКЕТИНГ
Генеративная оптимизация текстов без кода доступна любому бизнесу уже сегодня. Внедрение 4 правил форматирования превращает стандартный корпоративный блог в готовую базу знаний для поисковых нейросетей, обеспечивая бесплатный целевой трафик без раздувания штата копирайтеров.
Свяжитесь с нами
Настройте поток клиентов из генеративного поиска
Оставьте заявку на аудит вашего блога и внедрение системы автоматизированного создания контента от команды «Гибкий маркетинг». Развернем готовый блог под ключ с выводом материалов в ответы поисковых нейросетей.