1. От Preview к стабильному релизу: хронология и главные изменения
1.1. Что представляла собой Preview-версия и почему релиз состоялся через 5 дней
Выпуск предварительной версии и последующий релиз стабильной сборки Qwen4-Max разделили всего пять дней. 16 ноября 2026 года компания Alibaba официально представила флагманскую модель в статусе General Availability (GA). Столь короткий интервал между демонстрационным стендом и промышленным запуском обусловлен спецификой задач предварительного этапа: Preview-версия не являлась «сырым» прототипом, а служила инструментом калибровки маршрутизации экспертов под реальными пользовательскими нагрузками.
Главной целью предварительного публичного тестирования была верификация алгоритмов динамического распределения токенов (Gating Network) внутри колоссальной MoE-структуры. В лабораторных бенчмарках распределение нагрузки между экспертами часто демонстрирует идеальные показатели, однако в условиях разнородного входящего потока — от неструктурированных запросов на естественном языке до сотен тысяч строк исходного кода — роутер может сталкиваться с эффектом «перегрузки экспертов» (Expert Bottleneck), когда запросы концентрируются в ограниченном числе подсетей, вызывая просадку скорости инференса.
В ходе пятидневного нагрузочного теста инженеры собрали телеметрию по поведению модели на предельных объемах входных данных и оптимизировали критические узлы пайплайна:
- Калибровка функции внимания (Attention Decay Mitigation). В Preview-версии при приближении объема входящих данных к отметке 800–900 тысяч токенов наблюдались эпизодические потери логической связности и пропуски инструкций, расположенных в средней трети контекста (эффект «Lost in the Middle»). В стабильном релизе была скорректирована интерполяция позиционных эмбеддингов, что стабилизировало удержание контекста на всей дистанции в 1 млн токенов 2. Ликвидация зацикливаний при генерации синтаксических конструкций. На этапе тестирования при обработке сложных рекурсивных структур и объемных конфигурационных файлов модель периодически попадала в бесконечные циклы повторения токенов. В финальной сборке доработан штраф за повторения на уровне логитов роутера и улучшен алгоритм сэмплирования для кодовых блоков 3. Сокращение задержки до первого токена (TTFT — Time To First Token). Оптимизация параллелизма на стороне кластера и предвычисление маршрутов для стандартных шаблонов промптов позволили существенно снизить время первичного отклика в Cloud API.
1.2. Доступность весов и формат поставки
Политика распространения флагманской модели Qwen4-Max отражает общую тенденцию индустрии 2026 года: сверхкрупные архитектуры мультитриллионного масштаба поставляются исключительно в формате закрытого облачного сервиса. Веса модели на текущий момент не выложены в открытый доступ, и запустить ее на локальном сервере или персональной рабочей станции технически невозможно.
Причина такого решения лежит не только в коммерческой плоскости, но и в аппаратных ограничениях. Архитектура на 2,4 трлн параметров в формате квантования даже FP8 требует сотен гигабайт видеопамяти, распределенной по высокопроизводительному кластеру с интерконнектом уровня NVLink или аналогичных высокоскоростных шин. Развертывание подобного инференс-пайплайна требует промышленной серверной инфраструктуры, недоступной обычному бизнесу или отдельным разработчикам.
При этом разработчики официально подтвердили курс на поддержку open-source сообщества: запланирован поэтапный выпуск младших и дистиллированных версий семейства Qwen4 (модели классов 7B, 14B, 32B и 72B), которые получат открытые веса и смогут развертываться на локальных серверах компаний с жесткими требованиями к контуру безопасности On-Premise.
2. Архитектура MoE на 2,4 трлн параметров: как устроен инференс
2.1. Специфика Mixture-of-Experts: 71 млрд активных параметров
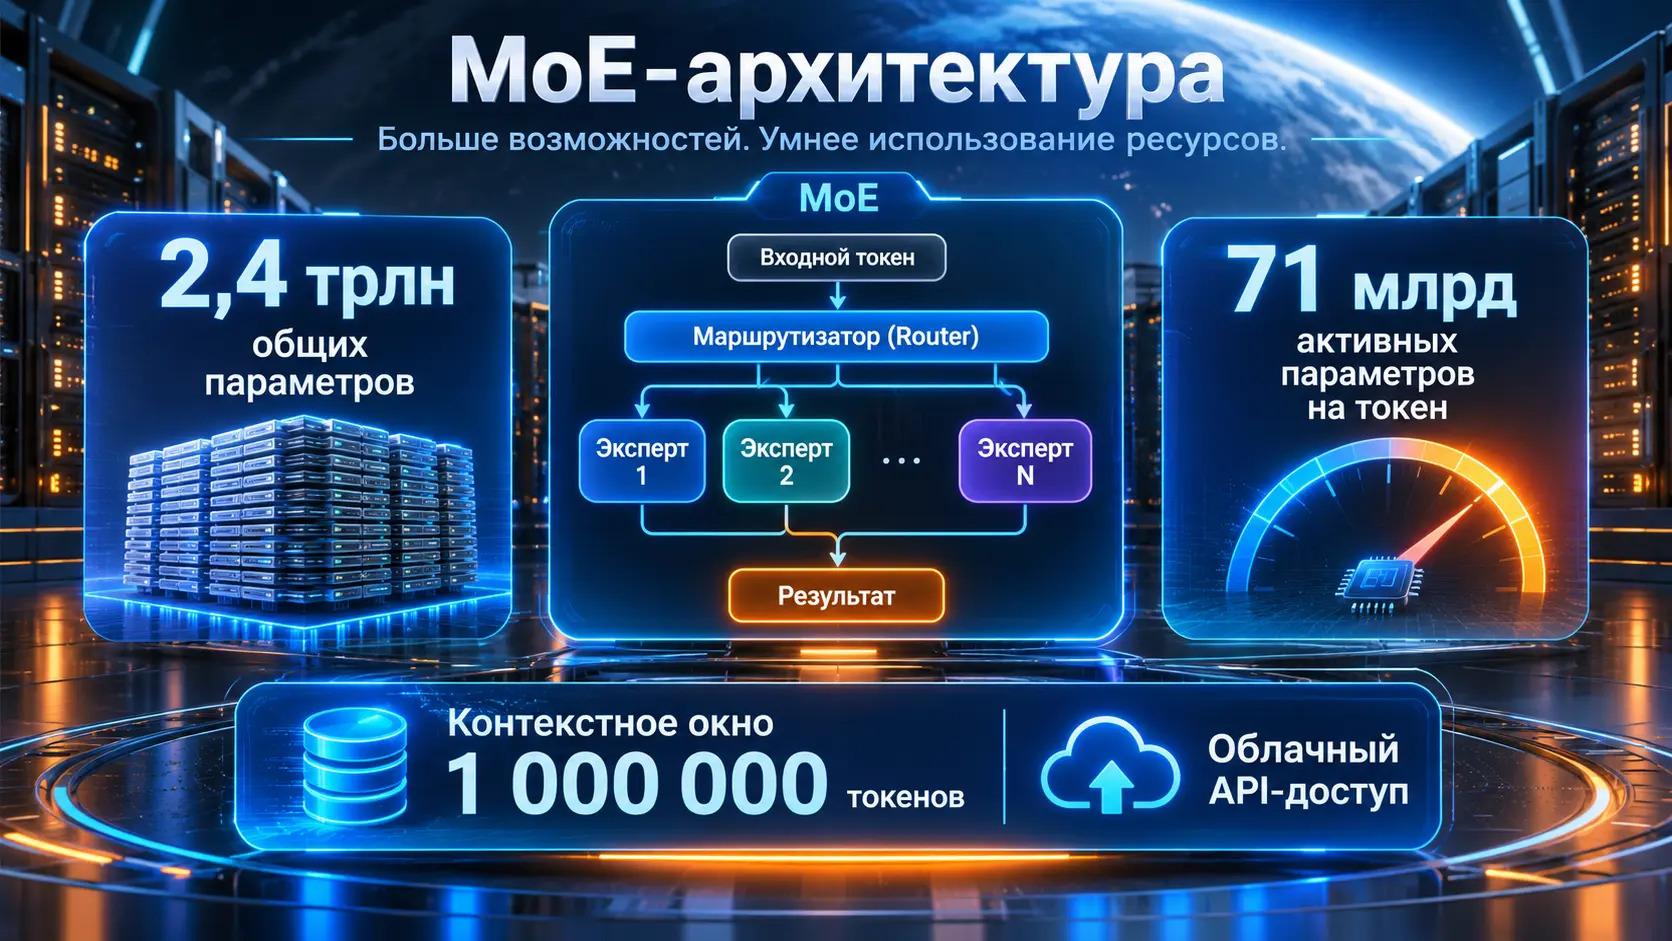
Архитектурный фундамент Qwen4-Max — разреженная смесь экспертов (Sparse Mixture-of-Experts). Общий пул параметров нейросети составляет 2,4 трлн, однако вычислительная сложность каждого шага генерации эквивалентна работе модели на 71 млрд параметров. Это фундаментальное инженерное отличие от классических «плотных» (dense) сетей.
В традиционной плотной архитектуре при вычислении каждого токена активируются абсолютно все веса модели. Если бы модель на 2,4 трлн параметров была плотной, инференс требовал бы колоссальных энергетических и вычислительных затрат, а генерация одного токена занимала бы секунды. В архитектуре Sparse MoE слои многослойного перцептрона (FFN) разделены на множество независимых блоков — «экспертов».
Механизм маршрутизации работает следующим образом: - Входной вектор токена поступает в шлюзовую сеть (Gating Network / Router). - Шлюз оценивает вероятностное распределение и выбирает ограниченное подмножество наиболее релевантных экспертов (Top-K routing) для обработки конкретного фрагмента данных. - Токены, связанные с логикой программирования, направляются в экспертные блоки, оптимизированные под синтаксис и алгоритмы; токены естественного языка или перевода — в лингвистические блоки; токены описания геометрии — в пространственные и мультимодальные эксперты. - На выходе результаты работы выбранных экспертов взвешиваются и объединяются.
Благодаря активации лишь 71 млрд параметров на токен достигается баланс между широтой накопленных знаний мультитриллионной модели и высокой скоростью генерации, пригодной для коммерческой интеграции через API. Это также существенно снижает конечную стоимость инференса для корпоративных клиентов.
2.2. Контекстное окно в 1 000 000 токенов: механика работы с кодовыми базами
Обработка сверхдлинного контекста в 1 млн токенов открывает принципиально новые возможности для разработки программного обеспечения и комплексной аналитики. В контекстное окно такого объема помещается более 750 тысяч слов текста или десятки тысяч строк программного кода вместе со всей сопутствующей документацией, спецификациями API и журналом изменений.
Традиционный подход к работе с большими базами знаний базировался на RAG (Retrieval-Augmented Generation) — фрагментации текстов на чанки, их индексации в векторной базе и последующем поиске релевантных кусков. RAG эффективен для простых вопросов, но регулярно дает сбои при анализе сквозных зависимостей в сложных кодовых базах, где функция из одного файла вызывает класс, определенный через три уровня абстракции в другом модуле.
С окном в 1M токенов Qwen4-Max позволяет загружать монорепозиторий проекта целиком: - Модель строит единый граф зависимостей непосредственно в пространстве внимания. - Исключаются ошибки потери контекста при межмодульных рефакторингах. - Тест «Needle In A Haystack» демонстрирует способность модели находить точечные инструкции и скрытые баги даже в массивах кода размером в сотни файлов.
Однако разработчикам важно учитывать инженерные правила работы с большим контекстом. Время обработки промпта (Prefill stage) линейно или квадратично (в зависимости от реализации внимания) возрастает с увеличением объема входных данных. Для оптимизации затрат и задержек критически важно использовать механизмы Prompt Caching (кэширование неизменяемой части кодовой базы на стороне провайдера), что позволяет повторно отправлять только дельту изменений.
3. Кодинг, вайб-кодинг и создание прототипов: тестирование возможностей
3.1. Генерация сквозных проектов: от фронтенда до 3D-игр
Флагманская модель Qwen4-Max изначально позиционируется как инструмент для «вайб-кодинга» (Vibe Coding) — парадигмы, при которой разработчик формулирует высокоуровневые концепции и архитектурные требования на естественном языке, а нейросеть берет на себя написание полной реализации, связывание компонентов и подготовку инфраструктурного окружения.
Модель демонстрирует глубокое понимание мультимодальных и графических интерфейсов: - Интерактивные 3D-сцены и WebGL. Qwen4-Max способна генерировать код на базе библиотек Three.js, Babylon.js и шейдеров GLSL. Модель корректно вычисляет пространственные координаты, векторы нормалей, настраивает источники освещения и связывает физику столкновения объектов с логикой управления с клавиатуры или мыши. - Full-stack веб-приложения. Нейросеть генерирует согласованный стек: типизированные структуры данных (TypeScript), компоненты пользовательского интерфейса (React, Vue, Tailwind CSS), серверные обработчики (Node.js, Go, Python), схемы баз данных (PostgreSQL, Prisma) и Docker-манифесты для развертывания. - Сложная бизнес-логика. За счет MoE-архитектуры модель удерживает строгие инварианты предметной области, корректно обрабатывая краевые состояния (Edge Cases), валидацию входящих потоков данных и структуры обработки ошибок.
3.2. Практический пример: шаблон постановки задачи на разработку сервиса
Для достижения максимального качества генерации при вайб-кодинге запрос должен содержать четкое разделение на функциональные слои, ограничения по стеку и критерии приемки.
Условный пример шаблона системной инструкции для генерации прототипа инструмента:
При подаче подобной структурированной спецификации Qwen4-Max последовательно выдает файлы проекта, исключая пропуски методов и оставляя детальные комментарии к сложным алгоритмическим участкам.
4. Агентный режим и автоматизация бизнес-процессов
4.1. Встраивание в цепочки автономных ИИ-агентов
Ключевой фокус Qwen4-Max — работа в качестве центрального мозга автономных агентских систем (Agentic Workflows). В отличие от простого диалогового режима, агентный сценарий предполагает, что нейросеть получает конечную высокоуровневую цель, самостоятельно строит план ее достижения, вызывает внешние сервисы и API, анализирует промежуточный результат и корректирует дальнейшие шаги.
Модель оптимизирована под работу в цикле ReAct (Reasoning + Acting) 1. Декомпозиция задачи. Модель разбивает абстрактный запрос (например, «Провести аудит производительности веб-приложения и составить отчет») на последовательность конкретных операций 2. Вызов инструментов (Function Calling / Tool Use). Qwen4-Max строго следует заданным JSON-схемам инструментов, безошибочно генерируя параметры вызова для внешних парсеров, баз данных или поисковых систем 3. Рефлексия и исправление ошибок. Если вызванный скрипт возвращает ошибку (например, HTTP 429 или синтаксический сбой в SQL), модель не прекращает диалог, а перехватывает сообщение об ошибке, модифицирует параметры запроса и повторяет попытку 4. Управление контентными и аналитическими конвейерами. Модель эффективно выступает оркестратором: собирает входящую информацию, структурирует сырые данные, формирует сценарии публикаций и отдает команды сервисам автопостинга.
4.2. Практическая интеграция через API: шаблон взаимодействия
Ниже представлен формат конфигурирования агентского запроса к Cloud API Qwen4-Max с описанием доступных внешних функций.
Условный пример вызова API Qwen4-Max в агентном сценарии:
5. Ограничения модели, безопасность и требования к инфраструктуре
5.1. Инженерные и операционные ограничения
Несмотря на флагманские характеристики, внедрение Qwen4-Max требует объективной оценки сопутствующих технических и бизнес-рисков:
- Закрытый контур поставки. Отсутствие доступа к весам модели делает невозможным развертывание в изолированных контурах On-Premise для организаций с критическими требованиями к защите данных (финансовый сектор, закрытые производственные базы). Все вызовы идут через внешнее облако 2. Экономика длинного контекста. Хотя контекстное окно в 1 млн токенов технически доступно, отправка сотен тысяч токенов в каждом запросе без продуманной архитектуры кэширования может привести к значительному росту операционных расходов на API 3. Сетевые задержки. При передаче объемных полезных нагрузок (Payload) через трансграничные каналы связи время передачи данных по сети может превышать время самого инференса. Для высоконагруженных production-систем требуется организация выделенных каналов или использование геораспределенных шлюзов.
Заключение
Полномасштабный релиз Qwen4-Max от Alibaba знаменует переход к зрелым MoE-решениям для масштабных инженерных задач. Благодаря архитектуре с общим пулом 2,4 трлн параметров и 71 млрд активных весов на токен, система демонстрирует высокую производительность инференса. Короткий этап Preview позволил точно откалибровать маршрутизацию экспертов под реальными нагрузками перед официальным запуском.
Контекстное окно объемом в 1 000 000 токенов с аппаратной стабилизацией внимания обеспечивает непрерывный поиск данных по всей глубине без фрагментации. Это открывает широкие возможности для работы со сложными кодовыми базами, глубокой аналитики, генерации 3D-сцен и сквозного вайб-кодинга с поддержкой вызова внешних инструментов.
Интеграция флагмана требует учета закрытого формата поставки через облачную платформу и Cloud API, а также контроля бюджета при регулярной обработке больших массивов данных. Для сценариев с жесткими требованиями к локализации следует ориентироваться на анонсированные открытые дистилляции модели.
