Как корпоративные сайты теряют видимость в генеративном поиске и что с этим делать — разбор механики, данных и стратегии GEO
1. Феномен невидимости: почему топ-10 SEO больше не гарантирует попадание в ответы ИИ
Суть проблемы
Представьте ситуацию: ваш корпоративный сайт стабильно держится в топ-10 классического поиска Google или Яндекс. Вы вложили ресурсы в SEO, проработали семантику, получили ссылки с авторитетных площадок. Потенциальный клиент вводит запрос «подрядчик по разработке под ключ в Москве» — и видит ваш сайт на третьей позиции. Всё работает.
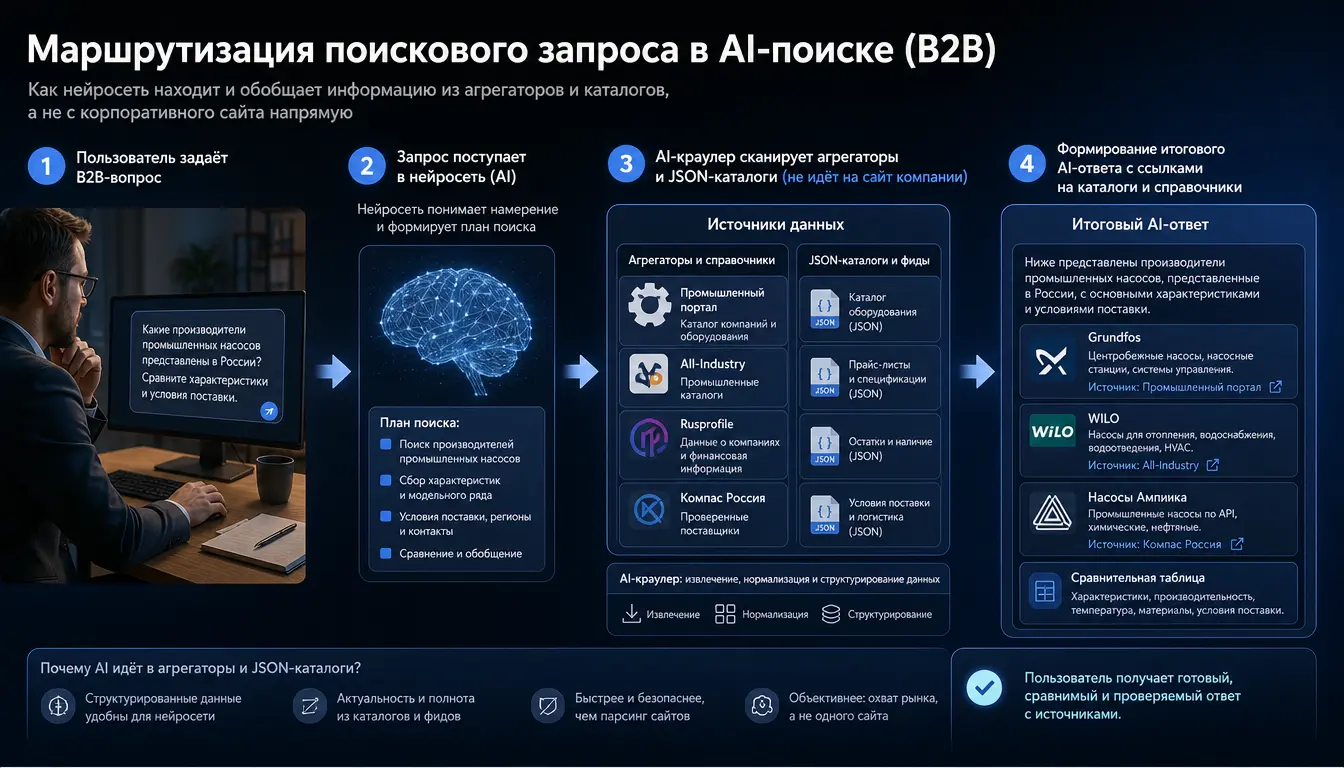
Но тот же клиент открывает ChatGPT, Perplexity или использует AI Overviews в Google и задаёт тот же вопрос. В ответ — список из пяти-семи компаний. Вашей среди них нет. Вместо прямых ссылок на сайты исполнителей нейросеть сгенерировала подборку из внешних каталогов, отраслевых справочников и агрегаторов. Ваш сайт, который вы так тщательно оптимизировали, просто исчез из поля зрения модели.
Это не сбой и не временная аномалия. Это новая реальность, в которой классическое SEO перестало быть достаточным условием для попадания в рекомендации генеративных систем. И масштаб проблемы гораздо серьёзнее, чем кажется на первый взгляд.
Эмпирические данные ресерча
Чтобы понять, насколько системно это явление, был проведён анализ на основе 200 реальных B2B-запросов на поиск исполнителей в различных отраслях: от разработки программного обеспечения до логистики и маркетинговых услуг. Методология заключалась в следующем: для каждого запроса фиксировалось, активируется ли генеративный ответ (AI Overview, синтезированная подборка ChatGPT или Perplexity), и какие источники модель использует для формирования рекомендаций.
Результаты оказались показательными. В 94 из 100 отраслевых подборок генеративный ответ действительно открывался — то есть модель сочла запрос достаточно конкретным, чтобы сформировать синтезированную рекомендацию, а не просто выдать ссылки. Однако корпоративные сайты поставщиков услуг практически не упоминались в источниках и рекомендациях. Вместо них модель опиралась на данные из открытых каталогов организаций, отраслевых реестров и агрегаторов.
Что это значит на практике? Даже если ваш сайт идеально оптимизирован для классического поиска, генеративная модель может его просто «не заметить», потому что её механизм отбора источников принципиально иной. Она не ранжирует страницы по ссылочной массе и релевантности контента — она ищет структурированные данные, которые можно верифицировать через множественные источники.
Подмена релевантности
Почему генеративные модели отдают приоритет вторичным источникам, игнорируя сайты-первоисточники? Ответ лежит в архитектуре Retrieval-Augmented Generation (RAG) — механизма, который большинство современных ИИ-поисковиков используют для формирования ответов.
RAG работает в два этапа. Сначала система извлекает релевантные фрагменты из своей базы знаний или индексированных документов. Затем генеративная модель синтезирует ответ на основе этих фрагментов. Ключевой момент: на этапе извлечения модель оценивает не «полезность» страницы для пользователя, а её «информационную плотность» и «надёжность» с точки зрения кросс-верификации.
Каталог, содержащий 50 стандартизированных карточек компаний с ценами, услугами, контактами и отзывами, для RAG-системы выглядит как более надёжный источник, чем корпоративный сайт одной компании, даже если этот сайт содержит исчерпывающую информацию. Почему? Потому что каталог предоставляет: - Высокую концентрацию структурированных фактов на единицу текста - Возможность триангуляции данных через множественные записи - Стандартизированный формат, снижающий затраты на парсинг
Корпоративный сайт, напротив, часто содержит «маркетинговую воду» — абстрактные формулировки, эмоциональные триггеры, брендовые слоганы. Для RAG-системы это шум, который снижает вес эмбеддинга страницы при поиске.
2. Логика работы ИИ-краулеров: почему модели выбирают каталоги и реестры
Фактор плотности сущностей
Чтобы понять, почему генеративные модели систематически предпочитают каталоги корпоративным сайтам, нужно разобраться в том, как LLM и поисковые агенты оценивают «концентрацию структурированных фактов» на странице.
Представьте два документа. Первый — корпоративный лендинг компании, занимающейся логистикой. На странице — красивые фотографии складов, анимация, блок с УТП «Мы обеспечиваем надёжную доставку по всей России», форма заявки и несколько абзацев текста о ценностях бренда. Второй — страница отраслевого каталога, где в табличном виде представлены 50 логистических компаний с полями: название, ИНН, регион работы, виды транспорта, минимальная партия, стоимость за километр, рейтинг, количество выполненных заказов.
Для человека второй документ выглядит как скучный справочник. Для RAG-системы это золотая жила. На одной странице каталога модель находит 50 сущностей (компаний), каждая из которых описана 8-10 атрибутами. Это 400-500 структурированных фактов, которые можно использовать для сравнения, фильтрации и рекомендации. Корпоративный лендинг содержит одну сущность (саму компанию) и, возможно, 10-15 фактов, разбавленных маркетинговым текстом.
Плотность сущностей — ключевой метрический показатель, который RAG-системы используют для ранжирования источников. Чем больше стандартизированных фактов на единицу текста, тем выше вероятность, что страница будет выбрана для формирования ответа. Каталоги выигрывают здесь с огромным отрывом просто по своей природе.
Синдикация и триангуляция данных
Второй фактор, работающий против корпоративных сайтов, — это механизм доверия модели к данным. Генеративные системы не верят самопрезентации. Они ищут подтверждение информации через множественные независимые источники — триангуляцию.
Когда модель видит на корпоративном сайте утверждение «Мы работаем с 2010 года, имеем 500+ выполненных проектов», она не может верифицировать это утверждение, если нет внешних источников, подтверждающих эти данные. В каталоге же та же компания может быть представлена с указанием года регистрации (из ЕГРЮЛ), количества проектов (из отзывов и портфолио на площадке), рейтинга (на основе оценок клиентов). Модель видит множественные пересекающиеся данные и делает вывод: информация надёжна.
Это создаёт парадоксальную ситуацию: даже если корпоративный сайт содержит абсолютно точные данные, модель может предпочесть каталог, где те же данные представлены в менее детальном, но кросс-верифицированном виде. Для бизнеса это означает, что недостаточно просто иметь сайт с информацией — нужно, чтобы эта информация была продублирована и подтверждена в авторитетных внешних источниках.
Форматы отдачи контента
Третий фактор — технический. Скорость парсинга и потребления токенов краулерами при обработке разных форматов контента существенно различается.
Корпоративные сайты часто перегружены JavaScript-фреймворками (React, Vue, Angular), которые требуют выполнения скриптов для рендеринга контента. ИИ-краулеры, такие как GPTBot, ClaudeBot, PerplexityBot и Google-Extended, могут обрабатывать JavaScript, но это значительно увеличивает стоимость парсинга в терминах времени и вычислительных ресурсов. Каталоги, напротив, часто отдают данные в чистом HTML с минимальным JS или предоставляют API-доступ к структурированным данным.
Особенно показателен случай с форматами отдачи. Некоторые современные каталоги предоставляют каждую карточку организации сразу в трёх форматах: HTML (для людей), Markdown (для LLM) и JSON (для API). Это означает, что ИИ-краулер может получить чистые данные без необходимости парсить и очищать HTML. Стоимость извлечения информации для модели снижается на порядки.
3. Почему llms.txt и базовый Markdown не спасают ситуацию автономно
Заблуждение о файле llms.txt
Когда проблема невидимости в генеративном поиске стала очевидной, многие SEO-специалисты и владельцы сайтов обратились к относительно новому инструменту — файлу
llms.txt. Идея проста: разместить в корне домена текстовый файл, который указывает ИИ-краулерам, какие страницы и в каком приоритете следует обрабатывать. Это аналог robots.txt, но для LLM.Однако практика показывает, что
llms.txt не решает проблему кардинально. Почему?Во-первых, файл
llms.txt лишь указывает краулерам приоритетные пути к текстовым данным. Он не меняет структуру контента на этих страницах. Если ваша страница услуг содержит абстрактные формулировки и маркетинговые клише, llms.txt не превратит её в структурированный источник фактов. Модель всё равно получит шум, а не полезные данные.Во-вторых,
llms.txt не решает проблему кросс-верификации. Даже если модель проиндексирует ваш сайт, она не сможет подтвердить достоверность данных без внешних источников. А без подтверждения модель с меньшей вероятностью включит вашу компанию в рекомендации.В-третьих, большинство генеративных систем используют RAG-архитектуру, где этап извлечения информации работает не на уровне отдельных URL, а на уровне семантических кластеров. Файл
llms.txt может помочь на этапе индексации, но не гарантирует, что ваши данные будут выбраны на этапе извлечения при конкретном запросе.Проблема «маркетинговой воды»
Корень проблемы глубже, чем технические форматы. Он в самом подходе к созданию контента для корпоративных сайтов.
Традиционное B2B-маркетинговое письмо строится на эмоциональных триггерах, брендовых историях и абстрактных обещаниях. «Мы — лидеры рынка», «Инновационный подход», «Индивидуальное решение для каждого клиента» — эти формулировки работают на людей, создавая доверие и формируя образ компании. Но для RAG-системы это шум.
Алгоритмы Retrieval-Augmented Generation оценивают вес каждого фрагмента текста при формировании эмбеддинга (векторного представления). Фрагменты с высокой информационной плотностью — конкретные факты, цифры, характеристики — получают высокий вес. Фрагменты с абстрактными формулировками — низкий вес. Если большая часть текста на странице состоит из «маркетинговой воды», общий вес страницы в поисковом пространстве снижается, и модель предпочитает другие источники.
Условный пример (все реквизиты и цены — заглушки). Как это выглядит на практике? Сравните два описания услуги:
Вариант А (традиционный корпоративный сайт): «Наша компания предлагает комплексные логистические решения, обеспечивающие надёжную доставку грузов по всей России. Мы используем современные технологии и индивидуальный подход к каждому клиенту. С нами вы можете быть уверены в сохранности вашего груза и соблюдении сроков доставки.»
Вариант Б (оптимизированный для ИИ): «Логистическая компания ООО «Пример», ИНН 0000000000, регистрация в 2015 году. Услуги: автоперевозки (фуры 20т, рефрижераторы), ж/д контейнерные перевозки. Маршруты: Москва — Санкт-Петербург (цена и срок — указать), Москва — Новосибирск (цена и срок — указать). Страхование грузов — включено. Лицензия Министерства транспорта № лицензии — указать.»
Вариант Б содержит конкретные факты, которые модель может использовать для сравнения, фильтрации и рекомендации. Вариант А — набор общих фраз, которые не несут полезной информации для RAG-системы.
Подробнее о том, как переписать коммерческие тексты и страницы услуг так, чтобы поисковые модели воспринимали их как фактологическую выжимку без лишнего шума, читайте в статье «4 правила текста для ответов нейросетей без кода 2026
4. Пошаговый план: как перестроить присутствие бизнеса под требования GEO (Generative Engine Optimization)
Шаг 1. Двойное присутствие (Hybrid Delivery)
Первый и самый критический шаг — обеспечить, чтобы ваш контент был доступен ИИ-краулерам в машиночитаемом формате без потери качества для человеческих посетителей.
Традиционный подход предполагает, что сайт должен быть либо «для людей» (красивый, интерактивный, с анимацией), либо «для машин» (чистый HTML, минимум JS). Но в 2026 году это ложная дихотомия. Нужно и то, и другое.
Что делать: 1. Внедрите альтернативный рендеринг страниц (SSR — Server-Side Rendering) для ключевых разделов. Это гарантирует, что даже если краулер не выполняет JavaScript, он получит полный HTML с контентом. 2. Создайте легковесные
.md (Markdown) версии ключевых B2B-страниц: описание услуг, портфолио, прайс-лист, кейсы. Разместите их в отдельной директории, доступной для краулеров, и укажите пути в llms.txt.- Используйте HTTP-заголовки
Vary: User-Agentдля определения типа клиента. Если запрос приходит от GPTBot, ClaudeBot или PerplexityBot, отдавайте упрощённую версию страницы без тяжёлых скриптов и анимации.
Пример реализации для Markdown-версии:
Создайте файл
/llm/services/logistics.md со следующим содержимым:Затем в
llms.txt укажите:Условный пример (шаблон):
Шаг 2. Развертывание глубокой семантической разметки
Второй шаг — создание строгих JSON-LD графов, которые связывают юридическое лицо, лицензии, команду и точные прайс-листы в единую семантическую сеть.
Стандартная микроразметка Schema.org, которую используют большинство сайтов, часто ограничивается базовыми типами
Organization и LocalBusiness. Для GEO этого недостаточно. Нужна глубокая разметка, которая позволяет модели строить полный граф сущностей.Что должно быть размечено:
- Organization — полные реквизиты: название, ИНН, ОГРН, юридический адрес, фактический адрес, телефон, email, сайт, дата регистрации 2. Service — каждая услуга с указанием: названия, описания, категории (по ОКВЭД или отраслевому классификатору), цены (с указанием валюты и единицы измерения), области оказания (география), условий 3. Offer — конкретные коммерческие предложения с ценами, сроками, условиями 4. Review — отзывы с указанием автора, даты, рейтинга, текста 5. Employee — ключевые сотрудники с указанием роли, компетенций, сертификаций 6. Product — если вы продаёте товары, а не услуги.
Пример глубокой разметки для услуги:
Такая разметка позволяет модели не просто найти вашу компанию, но и корректно сравнить её с конкурентами по ключевым параметрам: цена, сроки, география, наличие лицензий.
Шаг 3. Дистрибуция сущности по внешним каталогам
Третий шаг — обеспечение абсолютной идентичности контактных и фактологических данных (NAP: Name, Address, Phone, Services) во всех авторитетных справочниках, откуда ИИ черпает первичные списки кандидатов.
Это, пожалуй, самый трудоёмкий, но и самый критический шаг. Даже если ваш сайт идеально размечен и оптимизирован, модель может не включить вас в рекомендации, если ваши данные отсутствуют в ключевых каталогах, которые она использует как первичные источники.
Какие каталоги важны для B2B-видимости в ИИ-поиске:
- Отраслевые реестры и ассоциации — например, реестр IT-компаний при Минцифры, реестр логистических операторов, реестр строительных организаций. Модели доверяют государственным и отраслевым реестрам выше всего 2. Коммерческие каталоги с верификацией — 2ГИС, Яндекс.Карты, Google Business Profile, но с акцентом на полноту данных. Просто добавить компанию недостаточно — нужно заполнить все поля: часы работы, услуги, цены, фото, отзывы 3. Платформы с отзывами и рейтингами — Flamp, Zoon, Yell, Irecommend. Модели активно используют агрегированные рейтинги для ранжирования 4. Профильные B2B-площадки — для IT это может быть GitHub, Habr Career, для логистики — ATI.SU, для строительства — Госзакупки.
Критическое требование: синхронизация данных.
Ошибка в написании названия компании, разный юридический адрес на разных площадках,ные телефоны — всё это снижает доверие модели к вашим данным. Используйте сервисы управления репутацией или ручную сверку, чтобы NAP-данные были идентичны на всех площадках.
Чек-лист синхронизации: - Название компании (полное юридическое и краткое) — одинаково везде - ИНН — указан везде, где это возможно - Адрес — в едином формате (с индексом, регионом, городом, улицей) - Телефон — один основной номер для всех площадок - Сайт — один домен - Часы работы — одинаковые - Список услуг — единая классификация
Шаг 4. Оптимизация ответов на длинные хвосты запросов (Long-tail Q&A)
Четвёртый шаг — структурирование страниц услуг в формате чётких блоков «вопрос — технический ответ — параметры ограничения».
Генеративные модели особенно чувствительны к формату Q&A. Когда пользователь задаёт конкретный вопрос, модель ищет страницы, которые содержат прямые ответы на подобные вопросы. Если ваша страница услуг написана в формате «Мы делаем X, Y, Z», модель может не найти на ней ответ на конкретный вопрос «Сколько стоит доставка из Москвы в Новосибирск за 3 дня?».
Как перестроить контент:
-
Проанализируйте реальные вопросы, которые задают ваши клиенты. Используйте для этого: - Логи обращений в поддержку - Вопросы из чатов на сайте - Поисковые запросы, по которым вас находят (Google Search Console, Яндекс.Вебмастер) - Вопросы на форумах и в отраслевых сообществах
-
Для каждого вопроса создайте отдельный блок на странице услуги или отдельную страницу в формате FAQ.
-
Каждый блок должен содержать: - Чёткий вопрос (как его задаёт пользователь) - Конкретный ответ с цифрами и условиями - Ограничения и исключения (чтобы модель не рекомендовала вас там, где вы не работаете)
Пример оптимизированного блока:
Такой блок модель может использовать для прямого ответа на вопрос пользователя. Он содержит все необходимые данные: цену, сроки, условия, ограничения. И он размечен Schema.org, что дополнительно повышает его вес в RAG-системе.
5. Методика проверки видимости компании в поисковых нейросетях
Протокол тестирования
После внедрения изменений необходимо проверить, видят ли генеративные модели вашу компанию. Для этого разработайте протокол тестирования, который включает проверку в трёх ключевых системах: ChatGPT Search, Perplexity Pro и Google AI Overviews.
Шаг 1. Составьте проверочные промпты.
Промпты должны имитировать реальные запросы ваших потенциальных клиентов. Для B2B-компании это могут быть:
- «Подрядчик по [ваша услуга] в [ваш город] с опытом от 5 лет» - «Компания, которая делает [конкретная задача] с гарантией и лицензией» - «Сравнение [ваша компания] и [конкурент 1] и [конкурент 2] по цене и срокам» - «Нужен исполнитель для [конкретный проект с параметрами]»
Шаг 2. Запустите промпты в каждой системе.
Для чистоты эксперимента используйте: - Новую сессию (без истории диалогов) - Одинаковые настройки региона (если система позволяет) - Скриншоты или логирование полных ответов
Шаг 3. Зафиксируйте результаты.
Для каждого промпта запишите: - Появилась ли ваша компания в ответе - Если да — в каком контексте (прямая рекомендация, упоминание в списке, ссылка на сайт) - Какие источники модель указала в citations (ссылках под ответом) - Какие конкуренты появились в ответе и из каких источников
Анализ ссылочных источников (Citations)
Самый важный этап — анализ источников, которые модель указала под ответом. Это прямой ответ на вопрос, откуда модель берёт данные и почему она выбрала именно эти источники, а не ваш сайт.
Как разбирать citations:
- Откройте каждый URL, указанный в citations .
- Определите тип источника: - Отраслевой каталог - Государственный реестр - Платформа с отзывами - Новостной сайт - Блог или форум - Корпоративный сайт конкурента 3. Проверьте, есть ли ваш сайт среди citations. Если нет — это сигнал, что модель не считает ваш сайт авторитетным источником 4. Сравните citations для вашего запроса и для запросов конкурентов. Какие источники повторяются? Какие типы источников доминируют?
Пример анализа:
Допустим, вы задали запрос «Логистическая компания для доставки из Москвы в Новосибирск». Модель Perplexity выдала ответ с тремя компаниями и указала citations:
— карточка компании в каталоге ATI.SU 2.— каталог TransportRussia 3.https://delivery-logistics.ru/services/moscow-novosibirsk— сайт логистической компании
Вашей компании в ответе нет. Citations показывают, что модель использует два отраслевых каталога и один корпоративный сайт. Вывод: вам нужно присутствовать в ATI.SU и TransportRussia, а также оптимизировать свой сайт под формат, который модель считает релевантным.
Мониторинг логов краулеров
Третий элемент проверки — отслеживание активности ИИ-краулеров на вашем сервере.
Основные user-agent, которые нужно отслеживать:
GPTBot— краулер OpenAI (ChatGPT Search) -ClaudeBot— краулер Anthropic (Claude) -PerplexityBot— краулер Perplexity -Google-Extended— краулер Google для AI Overviews -CCBot— краулер Common Crawl (используется многими LLM) -Bytespider— краулер ByteDance (Doubao, Coze)
Как настроить мониторинг:
- Включите логирование HTTP-запросов на сервере (Nginx, Apache, или через панель хостинга) 2. Настройте фильтр для поиска строк, содержащих эти user-agent 3. Создайте дашборд или регулярный отчёт с метриками: - Количество запросов от каждого краулера за день/неделю/месяц - Какие страницы запрашиваются чаще всего - HTTP-статусы ответов (200 — успех, 403/404 — ошибки) - Время ответа сервера
На что обращать внимание:
- Если краулеры не посещают ваш сайт вообще — проверьте
robots.txt. Возможно, вы случайно заблокировали все ИИ-боты. - Если краулеры посещают только главную страницу, но не заходят на страницы услуг — проверьте внутреннюю перелинковку и карту сайта. - Если краулеры получают ошибки 403 или 404 — исправьте доступ к соответствующим разделам. - Если краулеры посещают сайт, но ваша компания не появляется в ответах — проблема не в индексации, а в качестве и структуре контента.
6. Ограничения исследования и выводы по адаптации B2B-сегмента
Фиксация ограничений данных
Любое исследование имеет ограничения, и этот анализ не исключение. Важно понимать контекст, в котором были получены данные, чтобы не делать ложных выводов.
Ограничения выборки: - Анализ основан на 200 B2B-запросах, что даёт репрезентативную, но не исчерпывающую картину. Поведение моделей может отличаться в зависимости от отрасли, региона и специфики запроса. - Данные собирались на основе открытого каталога организаций, где каждая карточка отдаётся сразу в HTML, Markdown и JSON. Это может создавать смещение в сторону каталогов с продвинутой технической реализацией. - Исследование фокусировалось на B2B-сегменте. В узких потребительских нишах B2C поведение моделей может отличаться, особенно если запросы имеют высокую эмоциональную составляющую или требуют субъективной оценки.
Ограничения по моделям: - Разные генеративные системы (ChatGPT Search, Perplexity, Google AI Overviews, Claude, Gemini) используют разные алгоритмы ранжирования источников. То, что работает для одной системы, может не работать для другой. - Модели постоянно обновляются. Алгоритмы, актуальные на момент написания статьи (ноябрь 2026), могут измениться в течение нескольких месяцев.
Ограничения по каузальности: - Корреляция между присутствием в каталогах и попаданием в ИИ-ответы не доказывает причинность. Возможно, модели выбирают каталоги не потому, что они лучше структурированы, а потому что они имеют более высокий авторитет в глазах системы. - Отсутствие компании в ИИ-ответах может быть связано не только с техническими факторами, но и с алгоритмическими предпочтениями модели, которые мы не можем полностью контролировать.
Синтез стратегии
Несмотря на ограничения, выводы исследования позволяют сформулировать чёткую стратегию адаптации для B2B-сегмента.
Ключевой сдвиг: SEO 2026 года трансформируется из работы с поисковыми системами в комплексную работу с открытыми базами данных, сущностями и оптимизацией машиночитаемости собственного сайта.
Три уровня адаптации:
-
Технический уровень: Обеспечить машиночитаемость контента через альтернативные форматы (Markdown, JSON-LD), SSR, HTTP-заголовки для краулеров. Это базовый уровень, без которого все остальные шаги бессмысленны.
-
Семантический уровень: Перестроить контент с маркетинговых формулировок на фактологические блоки с высокой плотностью сущностей. Внедрить глубокую микроразметку Schema.org, связывающую все аспекты бизнеса в единый граф.
-
Дистрибутивный уровень: Обеспечить присутствие компании в ключевых отраслевых каталогах, реестрах и платформах с отзывами. Синхронизировать NAP-данные на всех площадках. Создать кросс-ссылочную сеть, которая подтверждает достоверность информации о компании.
Что не работает: - Простое добавление
llms.txt без изменения структуры контента - Копирование контента с корпоративного сайта в каталоги без адаптации - Фокус только на одном канале (только сайт или только каталоги) - Игнорирование микроразметки и семантической связностиЧто работает: - Двойное присутствие (Human-readable + Machine-readable контент) - Глубокая семантическая разметка с полным графом сущностей - Присутствие в 3-5 ключевых отраслевых каталогах с верифицированными данными - Контент в формате Q&A с конкретными цифрами и ограничениями - Регулярный мониторинг видимости в генеративных системах
Заключение
Традиционное SEO в топ-10 классической выдачи больше не обеспечивает прямого попадания в ответы поисковых нейросетей вроде ChatGPT, Perplexity или Google AI Overviews. Алгоритмы генеративных систем отдают предпочтение отраслевым каталогам, агрегаторам и реестрам, ориентируясь на высокую плотность сущностей, триангуляцию данных и отсутствие маркетинговой воды.
Попытки решить проблему исключительно с помощью файла llms.txt или базового Markdown не дают автономного результата. Для эффективной адаптации в рамках GEO бизнесу требуется комплексная перестройка: внедрение гибридного формата отдачи контента, развертывание глубокой семантической разметки с полным графом сущностей и подтверждение сведений на авторитетных внешних площадках.
Успешное присутствие в генеративной выдаче строится на синдикации верифицированных данных в профильных каталогах и подготовке Q&A-материалов под длинные хвосты запросов с конкретными цифрами и ограничениями. Регулярный анализ логов ИИ-краулеров и мониторинг ссылочных источников позволяют своевременно оценивать реальную видимость компании.
