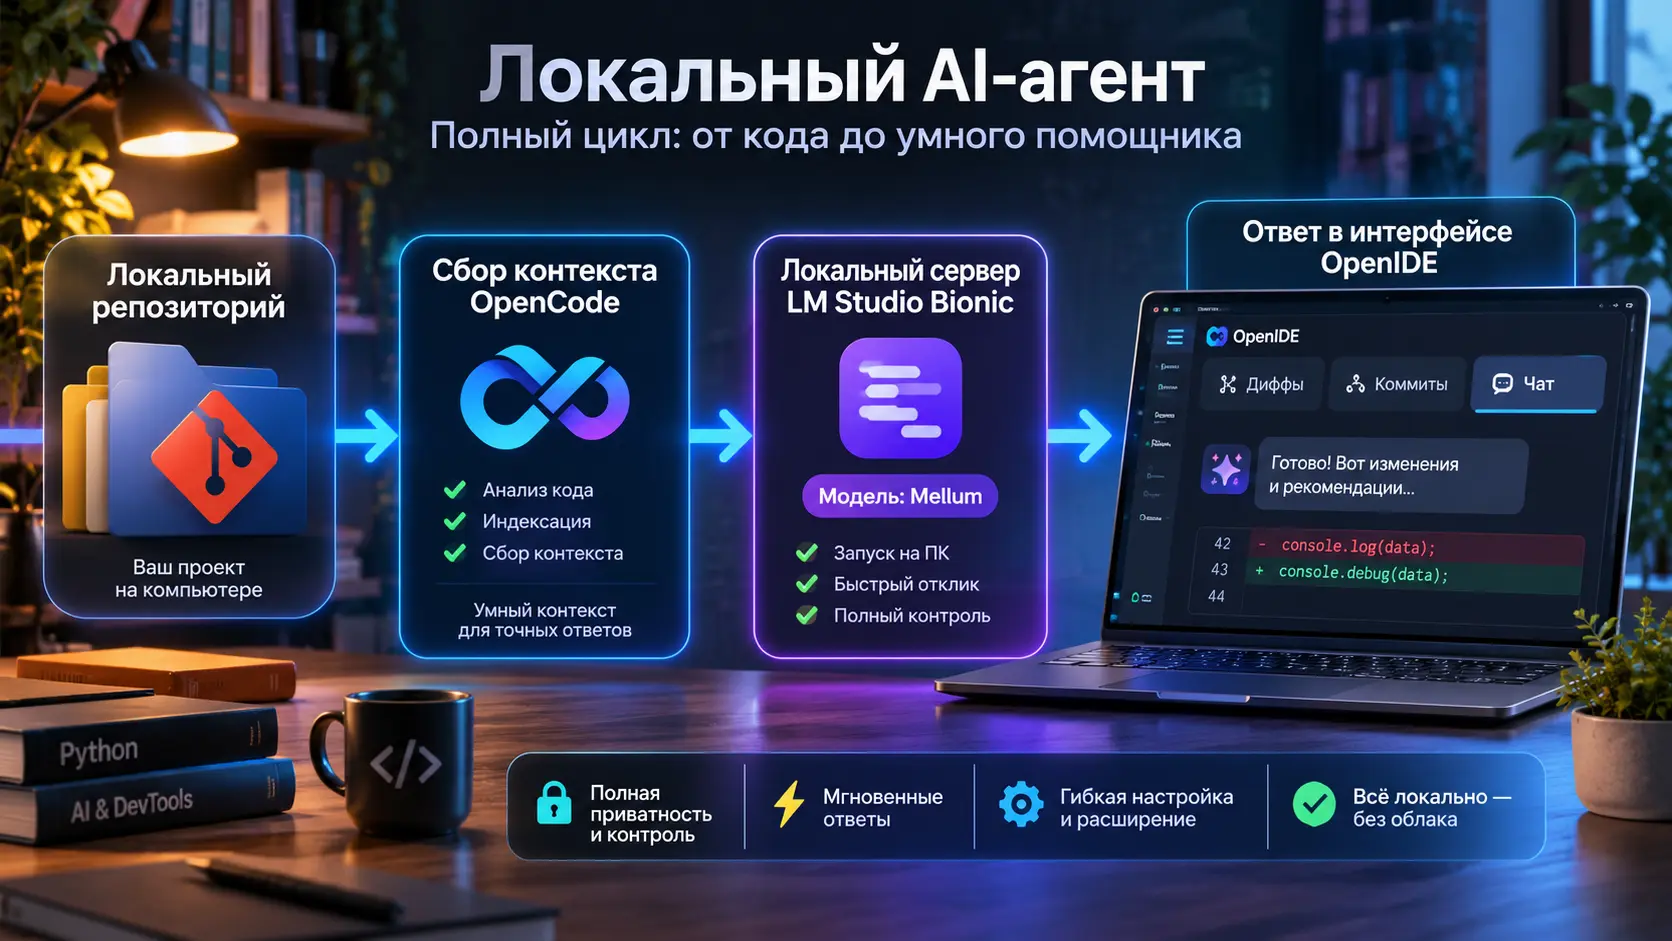
Инженерный разбор автономного стека разработки: изоляция кодовой базы, запуск специализированной модели Mellum через LM Studio Bionic и интеграция агентского пайплайна в редактор кода без передачи данных во внешние облака.
1. Архитектура локального кодинга: почему бизнес и разработчики уходят в оффлайн
Индустрия программной инженерии в 2026 году подошла к точке переосмысления облачных AI-ассистентов. Первоначальный энтузиазм от применения централизованных SaaS-решений столкнулся с фундаментальными барьерами безопасности, экономической целесообразности и стабильности сетевой инфраструктуры. Если на этапе ранних экспериментов отправка фрагментов кода на сторонние серверы воспринималась как неизбежный компромисс, то сегодня передача интеллектуальной собственности во внешние контуры становится для многих компаний неприемлемым операционным риском.
Контекст приватности и регуляторные ограничения 2026 года
Главным драйвером миграции на локальные языковые модели остается защита коммерческой тайны и чувствительных пользовательских данных. При работе с облачными Copilot-сервисами код, конфигурационные файлы, схемы баз данных и переменные окружения неизбежно передаются по открытым каналам связи на удаленные серверы. Даже при наличии строгих соглашений об уровне обслуживания (SLA) и заявлений провайдеров об отказе от дообучения моделей на пользовательских данных сохраняются следующие системные угрозы:
- Утечка учетных данных и секретов: случайное попадание приватных ключей шифрования, JWT-токенов, API-ключей сторонних сервисов и паролей от внутренних баз данных в тело промпта или контекстное окно сессии 2. Риски логирования на стороне провайдеров: перехват и долговременное сохранение промежуточных запросов во внешних логах аудита, доступных сотрудникам провайдера или уязвимых к компрометации через цепочки поставок (supply-chain атаки) 3. Регуляторное давление и отраслевые стандарты: требования локализации обработки данных в enterprise-сегменте, финансовом секторе, медицине и критической информационной инфраструктуре. В соответствии со стандартами безопасности код банковских систем и алгоритмы обработки персональных данных не могут покидать защищенный периметр предприятия.
Работа в полностью изолированных контурах (air-gapped environments) делает невозможным использование SaaS-ассистентов: рабочие станции инженеров физически или программно отрезаны от глобальной сети интернет. В таких условиях локально развернутая нейросеть становится единственным способом автоматизировать рутинные операции кодогенерации и рефакторинга.
Финансовая сторона вопроса также претерпела изменения. При масштабировании инженерных команд подписочная модель облачных ассистентов приводит к постоянному росту операционных расходов (OpEx). Подключение десятков и сотен специалистов требует ежемесячных лицензионных отчислений независимо от интенсивности использования инструментов. Переход на локальный стек трансформирует эти затраты в капитальные (CapEx) на закупку или модернизацию рабочих станций с достаточным объемом видеопамяти. Оборудование остается на балансе компании, а удельная стоимость каждого сгенерированного токена стремится к нулю.
Кроме того, автономный инференс снимает зависимость от внешней сетевой задержки (latency) и доступности зарубежных серверов. Локальный стек функционирует с постоянной скоростью генерации, не зависящей от сбоев магистральных каналов связи, блокировок протоколов или пиковых перегрузок инфраструктуры облачного провайдера.
Баланс аппаратных ресурсов: минимальные и рекомендуемые требования 2026
Современные компактные модели для программирования ориентированы на эффективную работу на потребительском и полупрофессиональном оборудовании. Производительность локальной LLM напрямую зависит от пропускной способности памяти (Memory Bandwidth) и объема доступной видеопамяти (VRAM).
Для комфортной работы в 2026 году критически важен баланс следующих компонентов:
- Видеопамять (VRAM): ключевой фактор, определяющий размер загружаемой модели и доступный размер контекстного окна. Для моделей класса 7B–9B в 4-битных и 8-битных квантованиях (AWQ, GGUF, EXL2) минимально необходимо 8 ГБ VRAM (например, графические ускорители уровня RTX 4060 / RTX 5060). Однако удержание широкого контекста (от 16k до 32k токенов) вместе с кэшем ключей и значений (KV-cache) требует от 16 ГБ до 24 ГБ VRAM (уровня RTX 4080 / RTX 4090 или объединенной памяти Apple Silicon от 32–64 ГБ). - Оперативная память (RAM) и процессор (CPU): при нехватке видеопамяти часть слоев нейросети может быть выгружена в системную память (GPU Offloading). Для бесперебойной работы операционной системы, IDE и процесса инференса требуется от 32 ГБ до 64 ГБ оперативной памяти стандарта DDR5 с высокой пропускной способностью. Многопоточный центральный процессор берет на себя вычисление весов, не поместившихся в видеопамять, однако скорость генерации в таком режиме снижается пропорционально объему выгруженных слоев. - Твердотельные накопители (NVMe PCIe 4.0/5.0): файлы квантованных весов занимают от 5 до 20 ГБ дискового пространства. Скорость последовательного чтения накопителя критична для минимизации времени «холодного старта» — первичной загрузки весов модели в оперативную и видеопамять при запуске локального сервера.
2. Развертывание Mellum через LM Studio Bionic
Для обеспечения высокой скорости инференса и минимального потребления памяти требуется специализированная среда выполнения, способная эффективно транслировать вычисления на тензорные ядра локального ускорителя. В связке рассматривается модель Mellum от JetBrains, оптимизированная для задач кодинга, и среда LM Studio Bionic, выступающая в роли локального сервера инференса.
Особенности модели Mellum от JetBrains
Mellum представляет собой семейство компактных языковых моделей, спроектированных специально для интеграции в инструменты разработки. В отличие от универсальных диалоговых LLM широкого профиля, архитектура и обучающая выборка Mellum сфокусированы на специфике программного кода:
- Продвинутое понимание синтаксических структур: модель обучена на массивах исходного кода с сохранением графов абстрактного синтаксического дерева (AST), что снижает число синтаксических ошибок в языках со строгой типизацией (Java, Kotlin, Rust, Go, TypeScript) и динамических средах (Python, JavaScript). - Специализация на Fill-in-the-Middle (FIM): архитектура изначально оптимизирована для предсказания фрагментов кода, находящихся между существующим префиксом и суффиксом файла. Это критично для мгновенного автодополнения строк и тел методов прямо во время набора текста. - Эффективное квантование: благодаря сбалансированному распределению весов модель сохраняет высокую точность при сжатии до форматов 4-бит и 5-бит (GGUF Q4_K_M, Q5_K_M), что дает возможность запускать ее на видеокартах с объемом памяти от 8 до 12 ГБ без существенной деградации логики.
Настройка инференса в LM Studio Bionic
LM Studio Bionic предоставляет графический и консольный интерфейс для управления локальными моделями, поддерживая аппаратное ускорение через Metal (для устройств Apple Silicon), CUDA (для видеокарт Nvidia) и ROCm/Vulkan (для AMD).
Процесс подготовки локального сервера инференса включает следующие шаги:
- Загрузка весов модели: через встроенный поиск каталога или ручной импорт GGUF-файла веса Mellum помещаются в локальное хранилище моделей 2. Конфигурация GPU Offload: в настройках инференса параметр числа выгружаемых на видеокарту слоев (
gpu_layers) выставляется на максимум, соответствующий полной загрузке модели в VRAM. Если объем видеопамяти составляет 16 ГБ, модель целиком помещается в память ускорителя, что обеспечивает максимальную скорость генерации (от 40 до 90 токенов в секунду в зависимости от поколения GPU) 3. Настройка контекстного окна и KV-кэша: размер контекста (Context Length) выставляется в диапазоне от 8192 до 32768 токенов. Для экономии памяти используется квантование самого KV-кэша (Flash Attention и FP8/Q8_0 кэширование), что позволяет удерживать длинные промпты без риска падения процесса по Out-Of-Memory (OOM) 4. Запуск локального API-сервера: LM Studio Bionic поднимает локальный HTTP-сервер, полностью совместимый со спецификацией OpenAI API (эндпоинты/v1/chat/completions,/v1/completions,/v1/models). По умолчанию сервер инициализируется на локальном адресеhttp://127.0.0.1:1234.
Условный пример команды проверки доступности и корректности инициализации локального сервера через консольный клиент:
После успешного ответа сервера с перечнем доступных моделей окружение готово к подключению внешних агентских надстроек.
3. Настройка автономного AI-агента OpenCode
Простого автодополнения строк кода по нажатию Tab недостаточно для решения комплексных инженерных задач. Разработка программных систем требует агентского подхода (agentic workflow), при котором автономный модуль способен анализировать проект целиком, выявлять межмодульные зависимости, читать и редактировать несколько файлов, а также проверять корректность своих изменений через запуск локальных тестов.
Роль OpenCode в архитектуре локального ассистента
OpenCode выполняет роль интеллектуального координатора между средой разработки, файловой системой проекта и локальной языковой моделью Mellum. В отличие от пассивных генераторов текста, агентский контур OpenCode реализует цикл «восприятие — планирование — действие — валидация»:
- Чтение файлового дерева: агент сканирует структуру проекта, фильтрует нерелевантные директории на основе правил
.gitignore, служебных папок сборщиков (node_modules,.git,dist,build) и формирует легковесную карту репозитория. - Инструментальный интерфейс (Tool Calling / Function Calling): агент взаимодействует с операционной системой через набор встроенных функций: чтение файла, запись файла, поиск по регулярным выражениям, выполнение команды в терминале и парсинг AST.
Подключение OpenCode к локальному серверу
Для перенаправления запросов с внешних облачных шлюзов на локальный инференс настраивается конфигурационный файл агента. Конфигурация указывает на локальный эндпоинт LM Studio, задает параметры температуры генерации и определяет стратегию сбора контекста.
Шаблон файла конфигурации подключения агента OpenCode:
Параметр
temperature: 0.2 обеспечивает детерминированность вывода, минимизируя случайные отклонения и синтаксические фантазии модели, что критично для генерации строго типизированного кода.Управление контекстом и ограничения памяти
Главная проблема локальных моделей при работе с крупными проектами — ограниченность контекстного окна и вычислительных ресурсов. Попытка передать весь исходный код репозитория в системный промпт неминуемо приведет к исчерпанию лимита токенов, резкому замедлению генерации и потере логической нити моделью.
OpenCode решает эту задачу с помощью многоуровневого управления контекстом:
- AST-индексация: вместо чтения «сырого» текста агент строит синтаксическое дерево исходных файлов. Это позволяет передавать в модель только сигнатуры функций, интерфейсы классов, типы данных и docstring-описания без передачи внутренних реализаций вспомогательных методов 2. Семантический локальный поиск (Codebase RAG): исходный код проекта разбивается на смысловые фрагменты (чанки по границам функций и классов), для которых локально рассчитываются векторные эмбеддинги. При формулировании задачи агент находит только те 3–5 фрагментов кодовой базы, которые непосредственно связаны с текущей задачей 3. Инкрементальный контекст диффов: при внесении правок модель получает только дельту изменений (diff) относительно исходного состояния файла, что экономит токены выходной последовательности.
4. Интеграция агента в рабочую среду OpenIDE
Максимальная продуктивность достигается тогда, когда агентский контур бесшовно встроен в ежедневный инструментарий разработчика — редактор кода, навигатор по файлам, панель системы контроля версий и терминал.
Создание бесшовного рабочего контура
Интеграция OpenCode в OpenIDE превращает редактор в единую командную консоль. Агент получает прямой доступ к контекстным событиям IDE и внутренним инструментам разработчика:
- Git-интеграция: агент считывает состояние рабочей директории (
git status), анализирует индексированные изменения (git diff --staged) и автоматически формирует стандартизированные сообщения коммитов, точно описывающие суть внесенных модификаций.
Условный пример шаблона системного промпта для генерации коммита на основе анализа Git Diff:
- Взаимодействие с клиентами баз данных: при наличии локальной схемы БД агент может генерировать SQL-миграции, валидировать структуры таблиц и предлагать оптимизированные индексы без отправки метаданных схемы во внешние облачные сервисы. - Интегрированный терминал и цикл обратной связи: при возникновении ошибок компиляции или падении юнит-тестов агент перехватывает вывод стандартного потока ошибок (
stderr), сопоставляет трассировку стека (stack trace) с номерами строк в исходных файлах и предлагает точечное исправление.
Настройка «горячих клавиш» и сценариев взаимодействия
Эргономика взаимодействия с локальной LLM настраивается под типовые сценарии:
- Inline Edit (редактирование по месту): выделение блока кода и вызов всплывающего поля ввода по комбинации клавиш. Агент модифицирует код непосредственно в редакторе с отображением двухпанельного диффа (Side-by-Side Diff) до применения изменений. - Генерация юнит-тестов и документации: контекстное меню позволяет в один клик сгенерировать набор тестов для текущего файла с мокированием внешних зависимостей. - Объяснение и аудит безопасности: анализ фрагмента кода на предмет утечек памяти, потенциальных race condition или уязвимостей перед отправкой в общий репозиторий.
5. Тестирование, валидация и реальные ограничения локальных моделей
Несмотря на технологический прогресс 2026 года, локальные компактные модели обладают специфическими ограничениями, которые необходимо учитывать при проектировании инженерных процессов.
Метрики точности и стабильности в 2026 году
Качество генерации кода локальными моделями оценивается по нескольким базовым параметрам:
- Процент компилируемости с первого раза (First-pass compilation rate): для типовых алгоритмических задач и стандартных библиотек компактные специализированные модели демонстрируют высокую стабильность. Однако при переходе к сложным абстракциям, нетривиальным типам или многопоточным конструкциям вероятность синтаксических и логических ошибок возрастает. - Галлюцинации в сигнатурах библиотек: если в обучающей выборке модели отсутствовали свежие версии конкретного фреймворка, локальная LLM может генерировать вызовы устаревших или несуществующих методов. - Эффект деградации внимания на длинных контекстах (Lost in the Middle): даже если архитектура поддерживает окно в 32k токенов, компактные веса хуже удерживают зависимости, находящиеся в середине длинного промпта, уделяя основное внимание начальным инструкциям и последним строкам запроса.
Методология верификации результатов разработчиком
Для предотвращения деградации кодовой базы работа с локальным AI-ассистентом строится по принципу Human-in-the-Loop («человек в контуре»):
- Обязательный статический анализ: любой сгенерированный фрагмент кода автоматически прогоняется через локальные линтеры (ESLint, Ruff, Clippy) и инструменты проверки типов (TypeScript Compiler, mypy) до сохранения в основную ветку 2. Изолированное исполнение: запуск сгенерированных агентом тестов и скриптов должен происходить внутри изолированных контейнеров (Docker, dev-контейнеры), чтобы исключить случайное выполнение деструктивных системных команд на рабочей станции разработчика 3. Финальное ревью инженера: разработчик несет персональную ответственность за архитектурную состоятельность, безопасность и читаемость кода, воспринимая AI-агента как высокоскоростного цифрового стажера.
6. Бизнес-применение: вайб-кодинг и автоматизация процессов агентства
Практическое применение локальных языковых моделей выходит далеко за рамки классической разработки программного обеспечения. В современных маркетинговых и продуктовых командах концепция автономного ассистента трансформируется в инструмент ускоренного прототипирования — так называемый «вайб-кодинг».
Как локальные агенты ускоряют разработку внутренних инструментов
В агентстве «Гибкий Маркетинг» подход на базе локальных и специализированных AI-ассистентов применяется для сборки внутренних микросервисов, парсеров и цепочек автоматизации без привлечения избыточных ресурсов full-stack разработки:
- Быстрое создание парсеров и сборщиков данных: локальные агенты генерируют типовой код для сбора открытой аналитики и тренд-вотчинга по социальным сетям и медиаплощадкам. Написание адаптеров для API, обработчиков структурированных данных и экспортеров в локальные хранилища занимает считанные минуты. - Разработка собственного генератора SEO-статей: кодогенерация и агентские пайплайны активно использовались при проектировании архитектуры нашего действующего продукта — генератора SEO-статей. Стек автоматизации позволяет разворачивать для клиентов готовые блоги, где публикации генерируются, структурируются, проходят автоматическую валидацию мета-тегов, индексируются поисковыми системами и привлекают бесплатный органический поисковый трафик. - Снижение барьера входа для технических специалистов: маркетологи и аналитики получают возможность самостоятельно собирать служебные скрипты автоматизации, связывать между собой различные платформы автопостинга и настраивать дашборды мониторинга реакций без необходимости ожидать выделения ресурсов от выделенного отдела разработки.
Автономный стек кодинга обеспечивает полную независимость бизнес-процессов: конфиденциальные маркетинговые связки, логика взаимодействия с базами данных и клиентские метрики остаются строго внутри корпоративного контура агентства.
Заключение
Переход на автономный стек разработки становится стратегическим решением для защиты интеллектуальной собственности и устранения рисков утечки приватного кода. Связка модели Mellum от JetBrains и рантайма LM Studio Bionic позволяет безопасно развернуть локальный AI-инструмент на собственном оборудовании с использованием аппаратного ускорения и GPU Offload.
Подключение агентского уровня OpenCode и его интеграция в OpenIDE формируют единую бесшовную среду для взаимодействия с кодовой базой. Агент берет на себя семантический поиск, индексацию AST и управление контекстом, эффективно работая с файлами проекта, терминалом, Git и клиентами баз данных без передачи информации во внешние облачные сервисы.
Автономная инфраструктура ускоряет создание внутренних инструментов, автоматизирует вайб-кодинг и закрывает регулярные инженерные задачи вроде рефакторинга, генерации тестов и документирования. При этом высокое качество кода обеспечивается обязательной экспертной верификацией результатов разработчиком.
