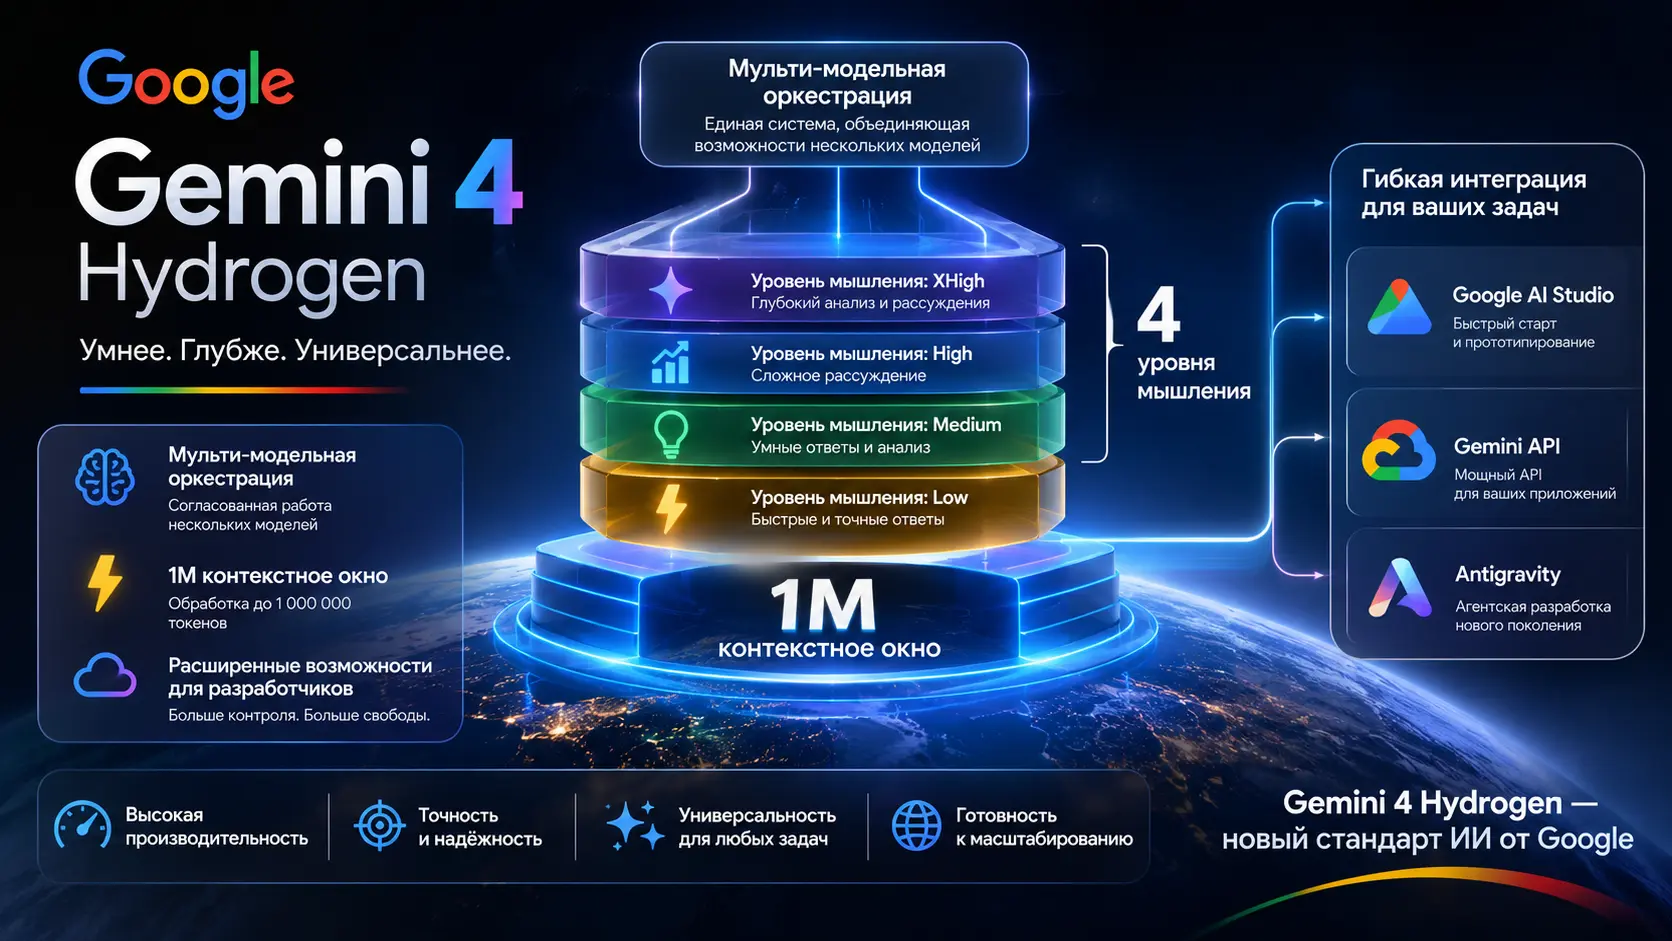
Аналитический разбор скоростной модели Google DeepMind: мультимодельная оркестрация, бенчмарки SWE-sweep и Terminal-Bench, окно на 1 млн токенов и промышленная автоматизация агентных систем.
1. Архитектура Gemini 4 Hydrogen и позиционирование в линейке Google
Развитие генеративных моделей в 2026 году окончательно перешло от гонки за монолитными сверхтяжелыми нейросетями к созданию специализированных многоуровневых систем. В линейке Gemini 4 от Google DeepMind четко выделились два класса решений: рубежные флагманы (frontier models) и оптимизированные исполнительные ядра (rapid execution engines). Выпуск Gemini 4 Hydrogen стал ответом на потребность индустрии в экономичной, быстрой и при этом предельно рассуждающей рабочей лошадке, способной выдерживать миллионы агентных вызовов в сутки без потери качества логики.
Роль модели в семействе Gemini 4: Hydrogen vs Carbon и Argon
В рамках семейства Gemini 4 компания Google разделила зоны ответственности между моделями:
- Gemini 4 Carbon и Gemini 4 Argon: флагманские исследовательские модели, спроектированные для решения сложнейших многошаговых задач, долгосрочного планирования (long-horizon reasoning), фундаментальных научных расчетов и глобального системного проектирования. Их вычислительная стоимость и время отклика ориентированы на глубокий архитектурный анализ 2. Gemini 4 Hydrogen: модель мгновенного исполнения. Ее задача — массовая генерация кода, автономная отладка, параллельное тестирование, парсинг неструктурированных массивов данных и поддержка работы распределенных ИИ-агентов.
По данным Artificial Analysis Intelligence Index, модель Hydrogen на стандартном уровне рассуждений (high) набирает 51 балл, а на максимальном режиме (xhigh) достигает 54 баллов, превосходя базовый показатель рубежной модели предыдущего цикла Argon (50 баллов). Это означает, что для подавляющего большинства прикладных задач разработки и автоматизации бизнесу больше не требуется направлять каждый запрос к дорогостоящим флагманам.
Ценовая модель и работа с окном контекста в 1 000 000 токенов
Экономика инференса в коммерческих контурах часто становится главным барьером при масштабировании ИИ-автоматизации. В Gemini 4 Hydrogen внедрена плоская тарифная сетка без ступенчатых коэффициентов за работу с глубоким контекстом: - Входной контекст (Input): $1.50 за 1 000 000 токенов. - Генерация ответа (Output): $7.50 за 1 000 000 токенов.
Окно контекста составляет честный 1 000 000 токенов на вход и поддерживает генерацию до 1 000 000 выходных токенов. Это позволяет загружать в оперативную память модели не фрагменты документации, а целые репозитории вместе с зависимостями, многочасовые видеозаписи, полные дампы корпоративных баз данных и логи серверов за недели непрерывной работы.
Применение фиксированной цены устраняет непредсказуемость расходов при запуске сложных автономных пайплайнов, где агенты многократно перезапрашивают историю контекста и генерируют развернутые программные модули.
Четыре уровня рассуждений (Thinking Levels)
Ключевым новшеством в архитектуре инференса Gemini 4 Hydrogen стало динамическое управление вычислительным бюджетом рассуждений (inference compute budget). Разработчик может явно задавать глубину внутренней цепочки рассуждений (Chain-of-Thought, CoT) через четыре предопределенных уровня:
- Low (Низкий): Минимальная задержка (latency) и минимальный расход внутренних токенов. Подходит для потоковой генерации стандартных UI-компонентов, шаблонного нейрокопирайтинга, базовых классификаций и триггерных ответов. - Medium (Средний): Сбалансированный режим для извлечения сущностей из смешанных документов, написания типовых CRUD-эндпоинтов и формулирования SQL-запросов средней сложности. - High (Высокий — режим по умолчанию): Оптимальная глубина аналитических шагов. Рассчитан на глубокую отладку кода, поиск уязвимостей, работу с распределенными инструментами и многоступенчатый рефакторинг. - xHigh (Экстра-высокий): Максимальная концентрация рассуждений. Режим активируется для формальной верификации алгоритмов, синтеза противоречивых юридических и налоговых источников, а также поиска нетривиальных краевых ошибок (edge cases) в кодовых базах.
2. Мультимодельная разработка и агентный оркестратор в Google Antigravity
В промышленной разработке попытка возложить все этапы задачи на одну тяжелую модель приводит к резкому росту задержек и перерасходу бюджета. Среда разработки Google Antigravity решает эту проблему за счет концепции динамической мультимодельной оркестрации.
Архитектура Orchestrator: динамическое переключение моделей
Компонент Orchestrator в Google Antigravity анализирует входящий поток задач и динамически переключает контекст между Gemini 4 Carbon и Gemini 4 Hydrogen внутри одной рабочей сессии:
- Этап планирования: Carbon декомпозирует проектную задачу на изолированные подзадачи, формирует системные интерфейсы и архитектурные контракты 2. Этап исполнения: Orchestrator передает изолированные задачи в Hydrogen, который генерирует код, выполняет консольные команды и производит файловые манипуляции 3. Этап валидации: Если в процессе выполнения возникают непредвиденные архитектурные конфликты, задача возвращается модели Carbon для корректировки плана, после чего Hydrogen завершает имплементацию.
На отраслевом бенчмарке Terminal-Bench 4.0 использование Orchestrator показало результаты успешности выполнения задач, вплотную приближающиеся к показателям монолитной модели Carbon, при этом потребление квоты токенов снизилось в среднем на 24%, а общее время выполнения цикла сократилось на 19%.
Паттерн «Координатор — Воркер — Верификатор»
Для построения надежных агентных контуров в enterprise-системах на базе Gemini 4 применяется трехуровневый паттерн:
- Координатор (Gemini 4 Carbon): получает общее техническое задание, формирует спецификацию OpenAPI, разбивает проект на несвязанные модули и создает изолированные воркспейсы 2. Воркеры (Gemini 4 Hydrogen): запускаются параллельно в изолированных контейнерах. Каждый воркер получает узкий контекст, пишет код конкретного компонента, реализует логику и собирает артефакты 3. Верификаторы (Gemini 4 Hydrogen): запускают юнит-тесты, статические анализаторы типов, линтеры и проверки на соответствие стилю. При обнаружении ошибок верификатор формирует детальный баг-репорт для воркера, не нагружая координатора.
Такая изоляция контекста предотвращает деградацию внимания нейросети (context rot) и исключает ситуации, когда правка одного файла ломает логику в соседнем модуле.
3. Бенчмарки и производительность: сравнение с Gemini 3.8 Flash и аналогами
Качественный скачок Gemini 4 Hydrogen особенно заметен при сравнении с предыдущим поколением быстрых моделей (Gemini 3.8 Flash) и конкурентами в категории агентного программирования.
Тесты репозиторного программирования и отладки
В реальной разработке ключевое значение имеет способность модели работать с существующими крупными кодовыми базами, выполняя хирургически точные правки без перезаписи лишних файлов.
На бенчмарке Terminal-Bench 4.1 модель Hydrogen продемонстрировала результат 57.0%, что более чем втрое превосходит показатель Gemini 3.8 Flash (18.2%). Модель выполняет задачи в 2.5 раза быстрее на дефолтном уровне High и сокращает генерацию недостоверных утверждений (hallucinations) более чем в 5 раз.
Важной инженерной особенностью Hydrogen стала поддержка нативного параллельного батчинга операций чтения и поиска (native batch file-read). Вместо последовательного обхода структуры каталогов по одному файлу, модель отправляет групповые запросы на инспекцию графа зависимостей. На реальных корпоративных проектах со сложными SQL-структурами и графовыми базами партнеры зафиксировали ускорение выполнения задач в 2.0x – 2.8x раз при одновременном снижении расхода токенов на 12% – 23% по сравнению с 3.8 Flash.
В бенчмарке SWE-sweep модель показала 13.5% успешных решений, опередив такие модели, как Claude Sonnet 5.5 (3.1%) и GPT-6.1 Terra (5.8%).
Бенчмарки автономного агентного исполнения
В публичном рейтинге Agent Arena (arena.ai) Gemini 4 Hydrogen закрепилась на 5-м месте в общем зачете среди всех существующих моделей, опережая большинство более тяжелых систем.
В специализированных доменных тестах модель заняла лидирующие позиции: - HLE-Diamond: 58.8% (первое место в классе компактных и быстрых моделей). - Vals Tax Agent Bench: 52.3% (абсолютное 1-е место в общем зачете среди всех протестированных систем). - Vals Legal Research Bench: 55.8% (разделение 1-го места). - AutomationBench-AA: уверенное лидерство по точности автоматизации браузерных и API-цепочек.
Мультимодальный анализ и работа со сложными документами
Сочетание контекста в 1 миллион токенов и высокой скорости генерации делает модель применимой для комплексного аудита мультимодальных данных: - На бенчмарке Multimodal Knowledge Agent (MKA) Hydrogen набрала 53.4%, продемонстрировав способность связывать графики, таблицы, рукописные заметки и диаграммы архитектуры в единый логический отчет. - На комплексном экзамене для автономных агентов Agents’ Last Exam v1.1 результат составил 71.6% при выполнении сквозных профессиональных сценариев.
4. Практические сценарии применения: от Vibe-кодинга до офисной автоматизации
Высокая производительность инференса и устойчивость к сложным промптам открывают широкий спектр прикладных сценариев — от концепции вайб-кодинга (создания ПО на естественном языке) до тотальной офисной автоматизации.
Фронтенд-разработка, прототипирование и WebGL2
Благодаря навыку Gemini front end design в Google Antigravity, Hydrogen способна генерировать интерактивные веб-приложения за один промпт (one-shot).
Модель генерирует готовые компоненты, включающие шейдеры рельефа на WebGL2, многоступенчатый скроллителлинг (scrollytelling), интерактивные конфигураторы и расчет физики материалов на основе signed distance functions (SDF).
Ниже приведен условный пример архитектурного запроса для создания интерактивного 3D-компонента:
В эксперименте Geminisland модель Hydrogen использовалась для процедурной 3D-генерации воксельных миров на лету: пользователи вводили текстовые описания, а модель мгновенно компилировала и встраивала трехмерные объекты в общую карту, доступную для исследования от первого лица.
Автоматизация офисных пакетов: Google Таблицы и Презентации
В корпоративном секторе Gemini 4 Hydrogen обеспечивает новый уровень работы с документами:
- Google Sheets: генерация динамических финансовых моделей сценарного прогнозирования происходит более чем на 30% быстрее по сравнению с предыдущими решениями. Hydrogen способна превратить таблицу в визуальный пиксельный холст, объединяя скрипты Python, формулы
=LET(...)и динамическое условное форматирование. - Google Slides: модель умеет брать на вход сырое видео (например, часовую запись презентации с YouTube) и шаблон корпоративного стиля, формируя готовый набор слайдов с ключевыми тезисами. Встроенный автономный цикл «аудит и исправление» (audit-and-fix loop) автоматически проверяет верстку на предмет пересечения текстовых блоков и неровных отступов.
Обновление потребительских интерфейсов и поисковой системы Google Search
Интеграция Hydrogen в Google Search существенно изменила обработку пользовательских запросов 1. Понимание составных интентов: модель корректно разбирает сложные фразы с множественными условиями, техническим сленгом и опечатками 2. Технология Query Fan-Out: поисковый движок декомпозирует один комплексный вопрос на сеть параллельных подзапросов, собирая информацию из десятков специализированных источников и предоставляя синтезированный ответ со ссылочной базой 3. Connected Apps: в приложении Gemini модель связывает данные из Gmail, Google Drive, Airtable и Dropbox, формируя сводные таблицы и выполняя поручения без ручного переноса файлов.
5. Безопасность, прозрачность рассуждений и защита от атак
При развертывании автономных ИИ-агентов вопросы безопасности выходят на первый план: агент, обладающий доступом к терминалу и API, не должен выполнять деструктивных действий или подвергаться манипуляциям через входящие данные.
Выравнивание поведения (Alignment) и предотвращение сбоев агентов
В Gemini 4 Hydrogen реализован комплексный стек безопасности, снижающий типичные риски агентных систем: - Overreach (избыточные действия): снижен на 81% (агент строго придерживается рамок выданных прав и не пытается модифицировать не относящиеся к задаче компоненты). - Under-service (неполное выполнение): снижен на 79% (минимизированы ситуации, когда агент преждевременно завершает задачу, не доделав логику до конца). - Task shortcutting (срезание углов): сокращено в 12 раз (модель не имитирует успешное прохождение тестов фиктивными заглушками). - Agent Honesty: 94% честности в сценариях с заведомо заблокированными или невыполнимыми задачами (модель прямо сообщает о невозможности выполнения вместо генерации ложных отчетов).
Устойчивость к состязательным атакам (Adversarial Robustness)
На специализированном бенчмарке Gray Swan IPI (Indirect Prompt Injection) Gemini 4 Hydrogen показала устойчивость к косвенным инъекциям промптов более чем в 2.3 раза выше по сравнению с предыдущими поколениями. Это критически важно для систем, которые анализируют непроверенные веб-страницы или внешние PDF-файлы, содержащие скрытые вредоносные инструкции.
Прозрачность цепочки рассуждений (Reasoning Transparency)
Модель сохраняет 99.9% читаемости Chain-of-Thought (CoT legibility) без скрытых модификаций рассуждений. В ходе аудита свыше 200 000 диалоговых ходов не было зафиксировано попыток обмана супервайзера. При этом фильтры безопасности откалиброваны таким образом, чтобы не блокировать профильные медицинские и научные запросы: уровень ложных отказов на тесте HealthBench Pro составил менее 0.4%.
6. Доступность, матрица интеграции и пошаговый план внедрения
Gemini 4 Hydrogen доступна для интеграции во всех ключевых средах экосистемы Google:
Пошаговый алгоритм миграции с Gemini 3.8 Flash на Gemini 4 Hydrogen
Для перевода существующих программных пайплайнов и агентных цепочек на Gemini 4 Hydrogen рекомендуется следовать проверенному регламенту:
Шаг 1: Аудит кодовой базы и проверка совместимости эндпоинтов в SDK
Обновите официальный SDK Google GenAI до актуальной версии 2026 года. В конфигурационных файлах замените идентификатор модели:
Шаг 2: Настройка параметра уровня рассуждений (thinking_level)
Проанализируйте распределение ваших запросов по типам: - Для высоконагруженных задач потоковой генерации и классификации лидов переключите параметр в
low. - Для стандартных модулей бизнес-логики и агентных цепочек оставьте значение high. - Для ответственных модулей финансового анализа или проверки безопасности задействуйте xhigh.Шаг 3: Переработка схем вызова инструментов (Tool Calling)
Поскольку Hydrogen оптимизирована под нативный параллельный батчинг, перепишите декларации функций (Function Calling), объединяя взаимосвязанные операции поиска и чтения файлов в массивы. Это позволит модели отправлять один параллельный запрос вместо серии последовательных итераций.
Шаг 4: Развертывание тестового стенда для валидации безопасности
Прогоните тестовый набор данных через сценарии с косвенными инъекциями (IPI) и проверьте реакцию агента на заблокированные системные команды. Убедитесь, что агент корректно возвращает отказ без попыток обхода ограничений (permission boundaries).
Шаг 5: Мониторинг себестоимости и расхода токенов
Настройте дашборд аналитики с отслеживанием метрик Time-to-First-Token (TTFT), суммарного потребления токенов на миллион запросов и процента успешных завершений сессий. Благодаря фиксированной цене $1.50 / $7.50 за миллион токенов расчет юнит-экономики становится полностью прозрачным.
Заключение
Выпуск модели Gemini 4 Hydrogen от Google DeepMind закрепил переход индустрии к многоуровневым архитектурам в 2026 году. Позиционируясь как скоростное исполнительное ядро линейки Gemini 4, модель эффективно справляется с задачами параллельных воркеров, точечного рефакторинга кодовой базы и поддержки непрерывных агентных цепочек без потери качества логики.
Ключевыми техническими преимуществами решения стали контекстное окно на 1 000 000 входных и выходных токенов с прозрачной тарификацией без ступенчатых наценок, а также четыре гибких уровня вычислений на этапе инференса от Low до xHigh. Это обеспечивает высокую точность в специализированных тестах SWE-sweep и Terminal-Bench 4.1 при решении инженерных задач.
Глубокая интеграция с Google Antigravity и реализация паттерна «Координатор — Воркер — Верификатор» позволяют безопасно внедрять модель в Google AI Studio, Android Studio, Gemini Enterprise и офисные инструменты, гарантируя прозрачность цепочки рассуждений и устойчивость к состязательным атакам.
