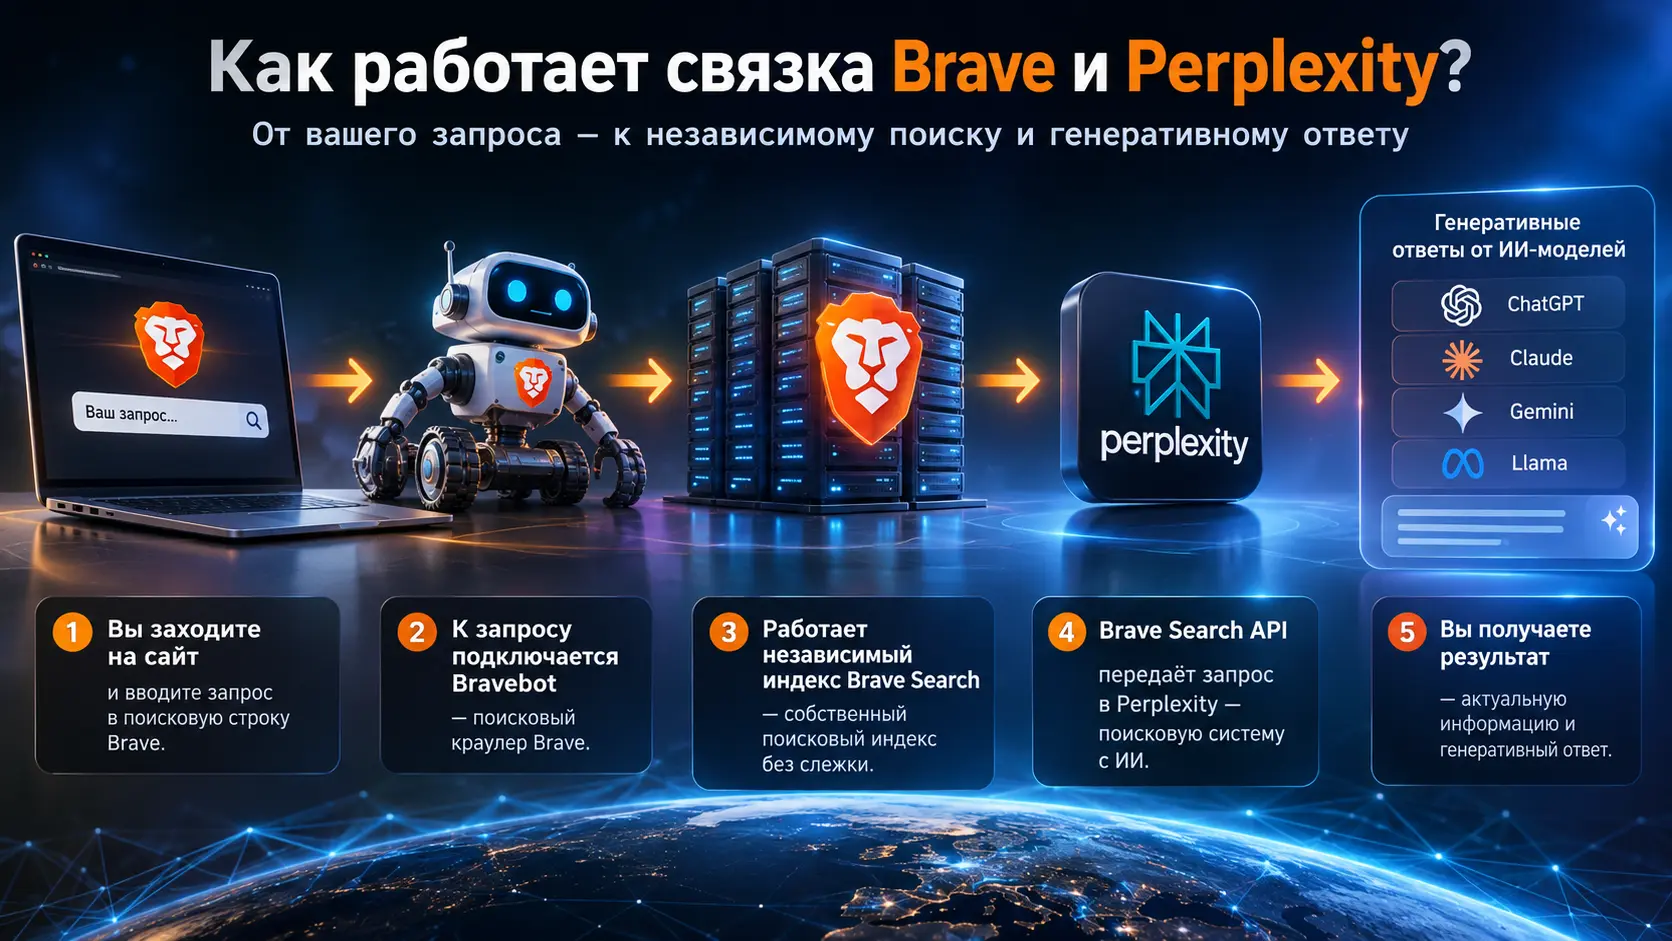
Практическое руководство по аудиту доступности веб-ресурса в поисковой базе Brave Search для попадания в выборку Perplexity и других генеративных ИИ-сервисов.
1. Новая реальность поиска: почему топов в Google и Яндексе недостаточно для ИИ
Смена парадигмы: от традиционной выдачи к генеративным ответам (GEO / LLMO)
В 2026 году ландшафт поискового маркетинга претерпел фундаментальную трансформацию. Годами выстроенные процессы оптимизации сайтов фокусировались на двух ключевых метриках: позициях в панели Google Search Console и показателях индексации в Яндекс Вебмастере. Однако привычная модель пользовательского поведения, когда человек кликает по первой синей ссылке на странице результатов поисковой выдачи (SERP), стремительно теряет долю рынка. Пользователи все чаще обращаются к генеративным системам и диалоговым ИИ-ассистентам — таким как Perplexity, поисковые боты нового поколения и специализированные агентские LLM-пайплайны.
Этот сдвиг породил новые дисциплины: Generative Engine Optimization (GEO) и Large Language Model Optimization (LLMO). В отличие от классического SEO, где конечной целью является клик и переход на целевую посадочную страницу, в генеративной оптимизации ключевая задача — попадание материалов сайта в корпус источников (grounding data), на базе которого нейросеть формулирует итоговый синтезированный ответ. Если сайт цитируется в блоке источников нейросети, бизнес получает наиболее качественный, прогретый и целевой трафик.
Главный подводный камень для маркетологов и владельцев сайтов заключается в скрытом разрыве инфраструктуры: большинство генеративных поисковых сервисов не занимаются сплошным обходом всего мирового интернета в режиме реального времени собственными силами. Для поддержания актуальности ответов и генерации ссылок они используют внешние коммерческие поисковые индексы через API.
Если страница проекта занимает первую строчку в выдаче Google и уверенно удерживает топ-3 в Яндексе, но отсутствует в поисковом индексе внешнего поставщика данных, к которому подключена конкретная нейросеть, этот материал физически не попадет в окно контекста модели (RAG-пайплайн). Модель не сможет прочитать текст, не использует его фактологию и не добавит кликабельную сноску на ваш домен. Чтобы понимать, как структурировать факты внутри страниц для подобных систем, рекомендуем изучить 4 правила текста для ответов нейросетей без кода 2026.
Как Brave Search стал ключевым поставщиком сырых данных для ИИ
Компания Brave изначально развивала свой поисковик как приватную альтернативу мировым монополиям, опираясь на собственный веб-краулер Bravebot. К 2026 году поисковая база Brave трансформировалась в один из крупнейших независимых западных индексов, полностью отвязанных от инфраструктуры Bing и Google.
Ключевым драйвером роста для поискового механизма Brave стала коммерциализация Brave Search API. В то время как классические поисковые корпорации ужесточали условия доступа к своим API, вводили запреты на использование результатов выдачи для обучения и аугментации моделей либо устанавливали заградительные тарифы, Brave сделала ставку на открытую продажу сырых структурированных результатов поиска разработчикам искусственного интеллекта.
Компания Brave открыто называет сервис Perplexity среди своих ключевых корпоративных клиентов. В момент, когда пользователь задает поисковый запрос в интерфейсе Perplexity, система выполняет обращение к партнерским поисковым шлюзам, среди которых Brave Search занимает критически важное место.
Если страница вашего сайта не проиндексирована роботом Bravebot или выпадает из выдачи Brave Search по целевым сущностям, партнерские ИИ-сервисы не получают соответствующий сниппет. В результате сайт оказывается отрезан от растущего сегмента AI-трафика, независимо от бюджета, вложенного в классическое продвижение.
2. Архитектура работы: как нейросети обращаются к индексу Brave
Механика Retrieval-Augmented Generation (RAG) в поисковых нейросетях
Чтобы выстроить системный аудит индексации, необходимо детально разобрать внутреннюю архитектуру современных поисковых LLM-систем, функционирующих на базе конвейера RAG (Retrieval-Augmented Generation — генерация с расширенным поиском данных).
Конвейер обработки пользовательского запроса состоит из последовательных шагов:
- Формирование поисковой стратегии (Query Formulation): Пользователь вводит многосоставный запрос на естественном языке (например, «какие инструменты вайб-кодинга и ИИ-автоматизации актуальны для малого бизнеса в 2026 году»). Большая языковая модель анализирует запрос и преобразует его в серию коротких точных поисковых фраз, оптимизированных под традиционный синтаксис поисковых машин 2. Обращение к Search API: Поисковый оркестратор нейросети параллельно отправляет сгенерированные запросы во внешние поисковые системы, в частности в Brave Search API 3. Получение и фильтрация сниппетов: API Brave возвращает JSON-ответ, содержащий метаданные: заголовки, прямые URL-адреса и текстовые сниппеты страниц, ранжированных внутренним алгоритмом Brave 4. Реранжирование и семантический парсинг (Reranking & Extraction): Нейросеть сопоставляет полученные сниппеты с исходным запросом пользователя, отбирает наиболее релевантные фрагменты, а в ряде случаев загружает полные текстовые слепки страниц (deep fetch) 5. Контекстный синтез и цитирование (Grounded Generation): Отобранные фрагменты помещаются в системный промпт LLM в качестве проверенного контекста. Модель формирует итоговый текст ответа, расставляя цифровые сноски со ссылками строго на те URL-адреса, которые присутствовали в переданных сниппетах Brave.
Узким горлышком всей цепочки является шаг 2 и 3: если материал вашего блога или сервиса не входит в число документов, возвращаемых API Brave, страница не имеет ни единого шанса пройти на этап реранжирования и попасть в контекстное окно генератора.
3. Экспресс-проверка вручную: аудит страницы за 2 минуты
Пошаговый алгоритм ручной проверки через веб-интерфейс
Первичную диагностику присутствия вашего ресурса в базе Brave можно выполнить через публичный веб-интерфейс без использования специализированных скриптов.
Пошаговый регламент:
- Откройте поисковую строку по адресу
search.brave.com2. Введите специализированный операторsite:с указанием вашего домена для оценки общей глубины обхода сайта 3. Проверьте конкретный посадочный URL, скопировав точный адрес страницы после оператора 4. Осуществите поиск по уникальному фрагменту заголовка H1 или точной цитате из первого абзаца, заключив ее в кавычки.
Ниже представлен условный пример поисковых запросов для базового аудита:
Интерпретация результатов ручной выдачи
По итогам ввода команд в строку поиска анализируются три сценария:
- Страница найдена, сниппет актуален: URL выводится в результатах поиска, заголовок и сниппет соответствуют текущей версии материала. Это подтверждает, что краулер успешно посетил ресурс, добавил его в индекс, и страница готова к выдаче через Brave Search API 2. Страницы нет в выдаче («Ничего не найдено»): Документ отсутствует в базе Brave. Это свидетельствует либо о технических барьерах на уровне сервера (блокировка User-Agent, директивы meta noindex), либо о том, что краулер еще не обнаружил ссылки на ваш материал в общем веб-графе 3. Страница найдена, но кэш и сниппет устарели: Поисковик отображает заголовок или текст, удаленный несколько месяцев назад. Для RAG-систем это создает риск галлюцинаций и генерации неактуальной информации об услугах и ценах вашей компании.
4. Массовая автоматическая проверка через Brave Search API
Подготовка окружения и получение доступа к API
Для регулярного мониторинга корпоративного блога или интернет-магазина, содержащего сотни страниц, ручной аудит не подходит. Оптимальный метод — интеграция скрипта проверки статуса URL через официальный Brave Search API.
Для настройки процесса 1. Зарегистрируйте аккаунт на портале для разработчиков Brave Search API 2. Создайте проект и сгенерируйте API-токен (
X-Subscription-Token) 3. Сохраните токен в переменных окружения операционной системы (BRAVE_API_KEY).Если вы храните свои проекты и скрипты автоматизации в удаленном репозитории, следуйте базовым правилам безопасности и управления версиями, описанным в руководстве 7 шагов работы с GitHub для новичков (2026).
Скрипт массовой проверки пула URL
Ниже представлен шаблон скрипта на языке Python для автоматической проверки индексации перечня URL-адресов.
Экспорт и обработка результатов
В результате работы скрипта формируется массив данных со следующими статусами: *
Indexed — страница присутствует в выдаче и готова отдаваться в RAG-модели. * Missing — страница не найдена в индексе Brave, требуется техническая проверка доступности. * Domain Only — в выдаче появляется главная страница вместо глубокого целевого URL, что указывает на проблемы с обходом структуры сайта.Скрипт можно интегрировать в регулярный CI/CD-пайплайн аудита контента, формируя еженедельный дашборд доступности материалов для ИИ-поисковиков.
5. Сверка логов цитирования Perplexity и выдачи Brave Search
Методология сопоставления источников
Для оценки реальной отдачи от индексации в Brave Search маркетологи проводят кросс-анализ цитируемости в ИИ-интерфейсах.
Методика включает три этапа:
- Сбор пула нишевых промптов: Формируется список из 50–100 коммерческих и информационных запросов, которые ваша целевая аудитория задает нейросетям (например, «как автоматизировать монтаж видео нейросетями под ключ») 2. Логирование ответов и источников: С помощью автоматизированных скриптов запросы отправляются в API Perplexity. В логах фиксируются все URL-адреса, вынесенные нейросетью в блок «Sources» (Источники) 3. Кросс-сопоставление с Brave Search API: Каждый промпт параллельно отправляется в Brave Search API. Выполняется математический анализ совпадения первых 5 результатов выдачи Brave с источниками, процитированными Perplexity.
Практика показывает, что для информационных запросов и свежих новостных сущностей совпадение источников из топа Brave с итоговыми сносками в ответах Perplexity достигает высоких значений. Если ресурс систематически присутствует в топ-3 Brave Search по целевому кластеру, вероятность его цитирования в итоговом ответе нейросети многократно возрастает.
6. Как ускорить индексацию сайта роботом Bravebot и устранить ошибки
Настройка технических параметров для краулера Brave
Если проверка показала отсутствие страниц в индексе, в первую очередь необходимо исключить серверные и конфигурационные блокировки.
Brave Search использует краулер с системным идентификатором
Bravebot. Нередко веб-мастера используют устаревшие шаблоны конфигурации robots.txt, в которых закрыт доступ для всех роботов, кроме стандартных поисковиков.Ниже представлен корректный шаблон файла
robots.txt, разрешающий обход для робота Brave:Дополнительно убедитесь, что ваш Web Application Firewall (Cloudflare, DDoS-Guard или собственные правила Nginx/iptables) не блокирует IP-диапазоны Bravebot по признаку «подозрительный User-Agent» или чрезмерной частоте запросов (Rate Limiting).
Архитектурные требования: скорость, чистый HTML и микроразметка
Краулер Bravebot ориентирован на высокую энергоэффективность и скорость обработки страниц:
- Минимизация тяжелого клиентского JavaScript (CSR): Роботы, ориентированные на поставку сырых данных в LLM, тратят минимальное количество вычислительных ресурсов на рендеринг тяжелого клиентского JS. Контент страниц должен присутствовать в исходном HTML-коде (SSR или статическая генерация SSG). * Микроразметка Schema.org: Использование структурированных форматов JSON-LD (
Article,TechArticle,FAQPage,Product) позволяет парсеру Bravebot мгновенно выделить ключевые факты и передать их в Brave Search API в чистом виде. * Иерархия заголовков и плотность данных: Разделы должны иметь строгую логическую структуру (H1, H2, H3), без размытых абстрактных формулировок. * Sitemap.xml: Карта сайта должна быть валидной, содержать теги даты последнего изменения<lastmod>и быть доступной с минимальным временем ответа сервера (TTFB менее 200 мс).
Если ваш проект также производит мультимедийный контент, например подкасты или видеоматериалы, критически важно переводить их в текстовый вид для индексации. Как это сделать без лишних затрат, детально разобрано в статье Транскрибация аудио в текст локально и бесплатно: 5 шагов 2026.
7. Системный контент и автоматизация: как регулярно забирать органический и AI-трафик
Конвейер создания контента под поисковые алгоритмы 2026 года
Обеспечение видимости сайта в ответах нейросетей требует регулярного создания и обновления контента. Ручное написание сотен экспертных статей требует больших ресурсов, поэтому современные компании выстраивают автоматизированные контент-конвейеры.
В «Гибком Маркетинге» мы создали собственный инструмент — генератор SEO-статей. Мы ставим клиенту готовый блог «под ключ», в котором материалы автоматически генерируются, публикуются, структурируются под требования поисковых роботов и индексируются. Это позволяет стабильно получать бесплатный поисковый трафик как из традиционных систем (Google, Яндекс), так и через поставщиков данных для LLM вроде Brave Search.
Эффективная контентная стратегия 2026 года включает следующие уровни:
- Глубокий тренд-вотчинг: Автоматический мониторинг актуальных тем через парсеры социальных сетей, Telegram-каналов и видеохостингов для выявления растущего спроса до того, как он появится в классических базах ключевых слов 2. Фактологическая генерация: Создание текстов с четкой структурой, таблицами, списками и техническими разборами, которые поисковый краулер легко разбирает на факты для RAG-систем 3. Кроссплатформенный посев: Связка поискового блога с автопостингом в Telegram, ВКонтакте и другие соцсети для генерации первичных поведенческих сигналов и ускорения обнаружения ссылок роботами Bravebot.
Интеграция регулярной проверки доступности страниц в индексе Brave Search в единый контур поисковой оптимизации гарантирует, что создаваемый контент станет прямым источником ответов для аудитории, использующей нейросети.
Заключение
Трансформация поискового маркетинга и развитие направлений GEO и LLMO изменили правила ранжирования: теперь главной целью оптимизации является попадание сайта в корпус данных (grounding data) для нейросетевых ассистентов. Пользователи все чаще обращаются к диалоговым системам вроде Perplexity, поэтому одного присутствия в традиционной выдаче больше недостаточно.
Независимый поисковый индекс Brave Search и его краулер Bravebot играют ключевую роль в обеспечении работы механики Retrieval-Augmented Generation (RAG). За счет высокой пропускной способности API генеративные платформы оперативно получают сниппеты, минуя ограничения классических систем, и цитируют проверенные веб-ресурсы в синтезированных ответах.
Успешная работа с генеративным трафиком требует адаптации технической базы сайта под требования Bravebot. Необходимы регулярная автоматизация проверок пула URL, сопоставление выгрузок с логами ответов ИИ-агентов, а также поддержка чистого HTML-кода, микроразметки и высокой скорости загрузки.
