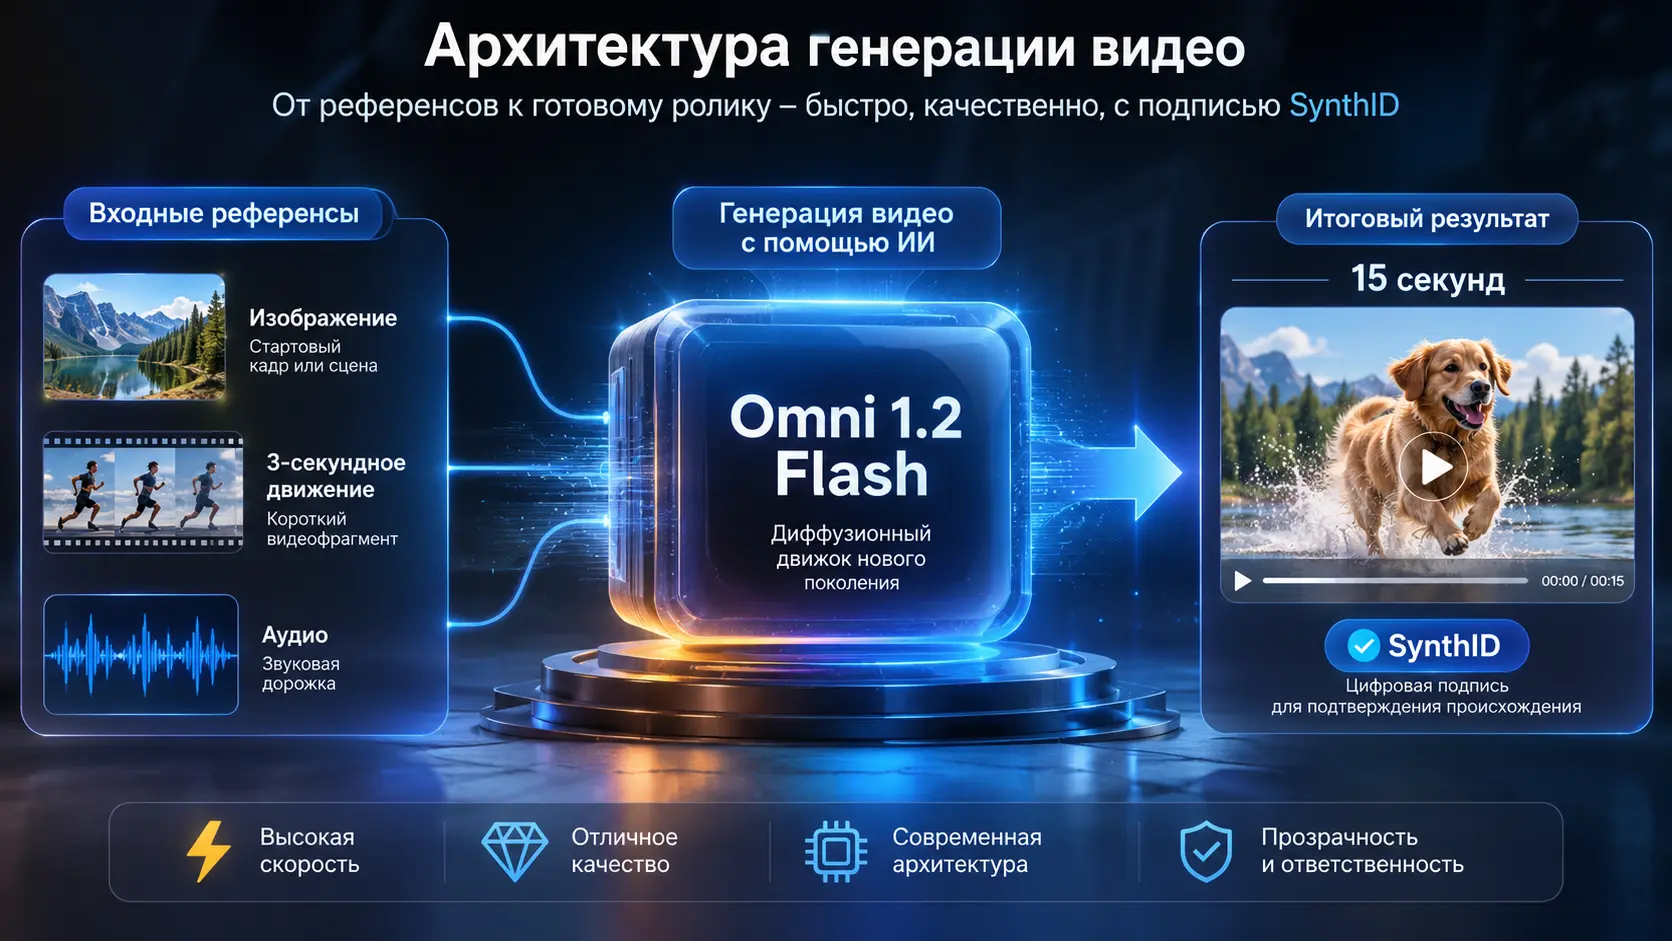
1. Архитектурные изменения и ключевые характеристики Gemini Omni 1.2 Flash
Выпуск генеративной модели Gemini Omni 1.2 Flash от Google DeepMind в ноябре 2026 года обозначил переход ИИ-видеогенерации из категории изолированных визуальных экспериментов в плоскость масштабируемых производственных пайплайнов. Предыдущие поколения видеомоделей сталкивались с фундаментальными барьерами: высокой вычислительной стоимостью одного прогона, жестким ограничением хронометража до 5–10 секунд и критической нестабильностью геометрии объектов при смене ракурсов камеры.
Архитектура Omni 1.2 Flash решает эти задачи за счет глубокой оптимизации механизмов пространственно-временного внимания (spatio-temporal attention) и внедрения сквозного мультимодального контекста. В рамках единого диффузионно-трансформерного контура модель способна одновременно обрабатывать текстовые описания, статические изображения высокого разрешения, трехсекундные видеореференсы движения и аудиодорожки. Это позволяет формировать кинематографические сцены с высокой предсказуемостью результата и минимальным уровнем пространственных галлюцинаций.
1.1. Увеличение хронометража: нативные клипы до 15 секунд
Ключевым инженерным новшеством модели стало увеличение предельной длины генерируемого фрагмента до 15 секунд в рамках одного прогона. В версии Omni 1.1 действовало нативное ограничение в 10 секунд, что вынуждало контентные команды дробить сценарии на микрофрагменты и вручную сшивать их во внешних монтажных программах с неизбежной потерей консистентности на стыках.
Особую практическую ценность для автоматизации представляет дискретный шаг настройки длительности: разработчик или режиссер монтажа может жестко задавать хронометраж от 3 до 15 секунд с шагом ровно в 1 секунду. Это устраняет необходимость пост-тайминговой обрезки кадров под хронометражные сетки рекламных платформ.
Такая гибкость тайминга кардинально меняет производство коротких форматов (Reels, Shorts, клипы VK, рекламные прероллы и карточки товаров для e-commerce). Пятнадцатисекундный отрезок укладывается в классическую трехактную структуру коммерческого ролика 1. Хук (0–3 секунды): динамическое привлечение внимания и экспозиция проблемы 2. Демонстрация решения (3–11 секунд): презентация продукта, показ функционала или разворот сюжетной линии 3. Призыв к действию (11–15 секунд): фиксация ключевого оффера, логотипа бренда и финального CTA.
Синтез подобного законченного смыслового блока без склеек исключает визуальный дрифт, когда от кадра к кадру незаметно меняются черты лица спикера или пропорции упаковки рекламируемого товара.
1.2. Экономика и ценообразование: оптимизация стоимости на 30%
Внедрение генеративных моделей в регулярные бизнес-процессы напрямую упирается в расчет unit-экономики. Разработчики Google DeepMind снизили стоимость инференса на 30% относительно предыдущей итерации: базовая ставка для видео в разрешении 720p зафиксирована на уровне $0.07 за одну секунду генерации.
Для минимизации издержек при масштабных объемах генерации предлагается трехступенчатый рабочий процесс (Drafting & Upscaling): - Быстрый драфтинг (Drafting): первичная сборка сцены и тестирование драматургии осуществляются в черновом разрешении 360p или стандартном 720p. Себестоимость полного 15-секундного черновика составляет порядка $1.05. - Итерационная коррекция деталей: вместо повторной генерации клипа с нуля режиссер вносит корректировки через диалоговые промпты, изменяя лишь целевые элементы сцены. - Финальный апскейлинг: только после финального утверждения раскадровки и динамики ролик отправляется на апскейл до коммерческих стандартов 1080p (Full HD) или 4K.
Такой подход сокращает производственный бюджет агентств и контент-отделов в 4–6 раз по сравнению с классическими пайплайнами, где каждая ошибка в промпте требовала полной платной перегенерации всей сцены.
2. Удержание референсов и консистентность объектов (Reference Adherence)
Одной из главных проблем нейросетевого видеопроизводства исторически оставалась нестабильность мелких деталей: при динамичном движении камеры логотипы расплывались, паттерны тканей деформировались, а лица актеров теряли портретное сходство с исходником. Gemini Omni 1.2 Flash содержит специализированный блок удержания референсов (Reference Adherence), фиксирующий геометрию объектов на протяжении всей траектории рендеринга.
2.1. Мультимодальный ввод: объединение стилей, движений и аудио
Модель поддерживает комбинированный стек входных данных. В единый промпт-контейнер могут быть переданы: - Изображение персонажа, реального физического продукта или мудборд стилистики; - Короткий видеоклип с динамикой движения (motion clip длительностью до 3 секунд); - Аудиосигнал с голосом диктора или темпоритмом фоновой музыки.
В процессе генерации Omni 1.2 Flash строго сохраняет такие параметры, как физика кроя одежды, драпировка текстиля, типографика на этикетках и точные hex-значения фирменной палитры бренда.
Наглядным сценарием применения технологии является виртуальная примерка одежды (Virtual Try-On) для ритейла. Имея на входе всего одну фотографию модели и снимки комплекта одежды спереди и сзади, система способна сгенерировать 15-секундный ролик с круговым облетом камеры на 360 градусов и монтажными склейками по движению (match cuts). При этом сохраняются пропорции тела модели, фактура ткани, форма строчек и элементы фурнитуры на спине.
2.2. Устойчивость первого и последнего кадров (First-to-Last Frame Consistency)
Для предотвращения визуального дрейфа (Visual Drift) в модель интегрирован механизм жесткой привязки граничных состояний (first-to-last keyframe interpolation). В традиционных моделях объекты к десятой секунде постепенно видоизменялись: пуговицы исчезали, формы окон трансформировались, а надписи превращались в абстрактный шум.
В Omni 1.2 Flash реализована точная интерполяция между заданными ключевыми кадрами. Например, задав экстерьерный вид здания на первом кадре и интерьер помещения на финальном, можно получить непрерывный пролет камеры внутрь объекта (Camera Push) с сохранением целостности архитектурных элементов.
Кроме того, модель демонстрирует способность к послойной сборке сложных статичных композиций. Если на вход подается постер с многослойной типографикой и световыми инсталляциями, система анимирует появление каждого элемента поэтапно — от включения неоновых нитей и преломления света в граненых кристаллах до финального рендеринга объемных букв на подиуме — удерживая тени и физические отражения стабильными до последнего кадра.
3. Диалоговое пошаговое редактирование (Multi-Turn Conversational Editing)
Возможность пошаговой доработки сгенерированного материала без необходимости повторного составления базового технического задания коренным образом меняет взаимодействие оператора с нейросетью.
3.1. Механика Turn-by-Turn корректировок
В основе диалогового редактирования лежит сохранение латентных репрезентаций (latent representations) предыдущей генерации в оперативной памяти сессии инференса. Модель не строит пиксельное пространство заново, а применяет градиентные маски к скрытым слоям диффузионного процесса.
Это открывает широкие возможности для быстрого создания вариаций под A/B-тестирование маркетинговых гипотез. Маркетолог может создать базовый ролик, а затем за несколько реплик адаптировать его под различные сегменты целевой аудитории.
Ниже представлен условный пример диалоговой сессии при подготовке рекламного креатива для линейки парфюмерии:
Еще одна примечательная функция — перенос динамики движения (Motion Transfer). В Turn 1 система может сгенерировать сложное волнообразное движение (например, колышущиеся щупальца осьминога в толще воды), а в Turn 2 заменить объект на платье танцовщицы, в точности повторив физику гидродинамических колебаний в складках шелковой ткани.
3.2. Синхронизация речи и многопользовательский звук (Lip-Sync & Multi-Speaker Conditioning)
Генерация синхронной речи в видеомоделях долгое время ограничивалась простым движением челюсти спикера невпопад звуковой дорожке. В Gemini Omni 1.2 Flash внедрен модуль артикуляционного кондиционирования (Multi-Speaker Lip-Sync).
Система способна принимать на вход односекундные голосовые сэмплы и привязывать их к конкретным визуальным персонажам в кадре. В одной 15-секундной сцене могут участвовать до четырех независимых персонажей: модель корректно маршрутизирует реплики, обеспечивает точное соответствие фонем движениям губ (viseme alignment), сохраняет паузы, эмоциональные интонации и естественную комедийную динамику диалога без рассинхронизации.
4. Кинематографический контроль камеры и сложные траектории
Профессиональное видеопроизводство требует строгого контроля за оптикой и поведением съемочной группы. Большинство нейросетей генерируют случайные покачивания виртуальной камеры, создавая неприятные рывки и скачки масштаба. Gemini Omni 1.2 Flash включает в себя алгоритмический модуль cinematic camera control.
4.1. Бесшовные непрерывные пролеты и масштабные зумы
Архитектура модели позволяет моделировать сложные кинематографические приемы без монтажных рывков (Zero Jump Cuts): - Сквозные FPV-пролеты: камера способна плавно пролететь через открытое городское пространство, миновать входной портал здания, подняться вдоль внутренней колоннады и устремиться в купольный свод. - Экстремальный непрерывный Crash Zoom-Out: непрерывный отъезд камеры от сверхкрупного макроплана (например, текстуры ракушки на песке) до высотной панорамы целого острова за 10 секунд с плавным изменением фокусного расстояния и реалистичным масштабированием ландшафта. - Орбитальная стабилизация: удержание фокуса на центральном объекте при быстром круговом облете с одновременным изменением угла наклона (tilt) и высоты.
4.2. Практический шаблон системного промпта для управления камерой
Для управления сложными траекториями через Gemini API применяется формализованный синтаксис параметров операторской работы.
Ниже приведен условный пример структуры JSON-запроса к API:
Такая стандартизация позволяет интегрировать видеогенератор в программные интерфейсы веб-сервисов и автоматизированных ботов, управляя ракурсами через строгие конфигурационные файлы.
5. Интеграция в экосистему и инфраструктурные сценарии
Развертывание Gemini Omni 1.2 Flash осуществлено сразу по всем ключевым уровням экосистемы Google: от интерфейсов прямого кодинга до потребительских облачных приложений.
5.1. Доступность для разработчиков и корпоративного сектора
Инфраструктурный стек включает следующие каналы доступа: - Google AI Studio & Gemini API: среда для прототипирования, тестирования промптов в интерактивном интерфейсе и прямой интеграции через REST API и SDK (Python, Node.js). - Google Cloud Console (Vertex AI): платформа корпоративного уровня, поддерживающая механизм гарантированной пропускной способности (Provisioned Throughput) с выделенными TPU-кластерами и строгим соответствием требованиям enterprise-безопасности. - Google Vids: интеграция в офисный пакет Google Workspace, где пользователи могут собирать презентационные и обучающие ролики на базе 15-секундных ИИ-клипов без дополнительной платы в рамках подписки. - Инструмент Flow (Google Labs): экспериментальная веб-студия для интерактивной режиссуры сцен и пошагового диалогового монтажа. - Google Ads Asset Studio: встроенный генератор рекламных креативов для автоматизированного создания видеообъявлений под кампании Performance Max и YouTube Shorts. - Gemini App: клиентский доступ для владельцев расширенных аккаунтов Google AI Ultra.
5.2. Безопасность и проверка подлинности: невидимый водяной знак SynthID
Все медиафайлы, сгенерированные моделью Omni 1.2 Flash, маркируются цифровым водяным знаком SynthID, разработанным в Google DeepMind.
В отличие от традиционных метаданных, которые легко стираются при перекодировании, SynthID внедряет скрытый псевдослучайный паттерн непосредственно в пиксельную матрицу каждого кадра. Водяной знак абсолютно невидим для человеческого глаза и не ухудшает визуальное качество картинки, но устойчив к: - Повторному перекодированию в форматы H.264, H.265 и AV1; - Агрессивному сжатию алгоритмами социальных сетей; - Обрезке краев кадра (кроппингу) и наложению цветовых фильтров.
Наличие SynthID обеспечивает прозрачность происхождения контента и соответствие международным стандартам маркировки синтетических медиа.
6. Ограничения модели, технические нюансы и рекомендации по внедрению
Несмотря на технологический прогресс, генеративные видеомодели остаются вероятностными системами, обладающими рядом физических и вычислительных ограничений, которые необходимо учитывать при проектировании продакшен-пайплайна.
6.1. Текущие ограничения и зоны доработки
Google DeepMind открыто отмечает аспекты, требующие дальнейшей инженерной доработки: - Высокодинамичные спортивные сцены: при симуляции быстрого хаотичного движения конечностей атлетов или полета мяча на высоких скоростях возможны артефакты размытия и анатомические неточности. - Сложная физика столкновения твердых тел: эффекты разрушения объектов, разбрызгивания вязких жидкостей или переплетения канатов могут просчитываться с нарушениями законов гравитации и сохранения импульса. - Радикальные скачки в сценарии (Script Shifts): попытка в рамках одного шага диалога полностью изменить действие персонажа (например, мгновенно перевести стоящего человека в бег с препятствиями) может привести к морфингу фигуры. Рекомендуется разбивать резкие изменения на 2–3 промежуточных итерации.
Заключение
Gemini Omni 1.2 Flash от Google DeepMind переводит генерацию коммерческого видео на новый уровень за счет нативной длительности роликов от 3 до 15 секунд с шагом в одну секунду. Технология мультимодального ввода позволяет фиксировать внешность персонажей, геометрию брендинга и использовать моушн-клипы длительностью до 3 секунд, сохраняя стабильность от первого до последнего кадра.
Пошаговый диалоговый пайплайн Multi-Turn дает возможность вносить точечные правки без потери пространственного контекста сцены. Встроенный синхронный Lip-Sync с поддержкой нескольких говорящих персонажей и расширенный контроль траекторий камеры существенно упрощают создание динамичных роликов с плавными пролетами и масштабными зумами.
Доступность через Gemini API и Google Cloud Vertex AI вместе с интеграцией в Google Vids и защитой SynthID формирует готовую инфраструктуру для корпоративного использования. Сниженная до $0.07 за секунду стоимость рендеринга в 720p делает генерацию экономически обоснованной, требуя лишь контроля ограничений в сценах со сверхбыстрой динамикой и сложной физикой.
